Theppitak's blog

My personal blog.

23 มิถุนายน 2564

Norasi Small Caps and Old Style Figures

ฟอนต์ Norasi เพิ่มการรองรับการใช้ small caps และ old style figures (ตัวเลขอารบิกแบบหนังสือยุคเก่า) แล้ว ทั้งใน OpenType และ LaTeX

PUA Glyphs

ฟอนต์ Norasi (ฟช ๓ จากโครงการฟอนต์แห่งชาติของเนคเทค) มี PUA glyph สำหรับตัว small caps และตัวเลขอารบิกในหนังสือยุคเก่า (old style figures) มานานแล้ว ผมไม่แน่ใจว่ามีมาตังแต่แรกเริ่มที่นำฟอนต์มาจากโครงการ Omega เลย หรือว่ามาเพิ่มเอาทีหลังใน TLWG เนื่องจากผู้ที่ทำงานกับ Norasi ในช่วงต้นจะเป็นคุณทิม (ชนพ ศิลปอนันต์) เป็นหลัก แต่มันก็อยู่ในรูป glyph ที่มีรหัสยูนิโค้ดในช่วง Private Use Area (PUA) พร้อมกับชื่อ glyph แบบ Postscript ตามอย่าง Adobe Glyph List เช่น เลขศูนย์แบบเก่ามีรหัสยูนิโค้ด U+F730 และมีชื่อ glyph เป็น zerooldstyle และตัว A small caps มีรหัสยูนิโค้ด U+F761 และมีชื่อ glyph เป็น Asmall เป็นต้น

PUA glyph เหล่านี้ โดยปกติจะไม่ใช้ในข้อความ แต่จะใช้เป็นการภายในของตัววาดข้อความ ในทำนองเดียวกับวรรณยุกต์ตัวต่ำ สระบนหลบหาง ป ฝ ฟ และสระอุ อู หลบหาง ฎ ฏ ในอักษรไทยนั่นเอง เท่ากับว่า PUA glyph เหล่านี้มีอยู่ แต่ยังไม่พร้อมใช้ ยกเว้นในระบบที่พยายามจะใช้ PUA เหล่านี้จริงๆ

OpenType

ขณะเดียวกัน เราจะเห็นแอปพลิเคชันสมัยใหม่พยายามรองรับ OpenType feature ต่างๆ ใน UI มากขึ้น จากเดิมที่มีแต่ใน desktop publishing หรูๆ ตอนนี้แม้แต่ word processor อย่าง LibreOffice Writer และ MS Word ก็เริ่มมี UI สำหรับเลือกเปิด/ปิด discretionary feature (ฟีเจอร์ที่กำหนดใน mark up ของเอกสาร และอาจจะผ่าน UI ให้ผู้ใช้เลือก) ของ OpenType แล้ว ซึ่ง small caps (smcp) และ old style figures (onum) ก็เป็นฟีเจอร์ชนิดนี้

หลังจากเพิ่มฟีเจอร์ดังกล่าวในฟอนต์ Norasi แล้วทดลองใช้กับ LibreOffice Writer ก็ได้ผลดังนี้:
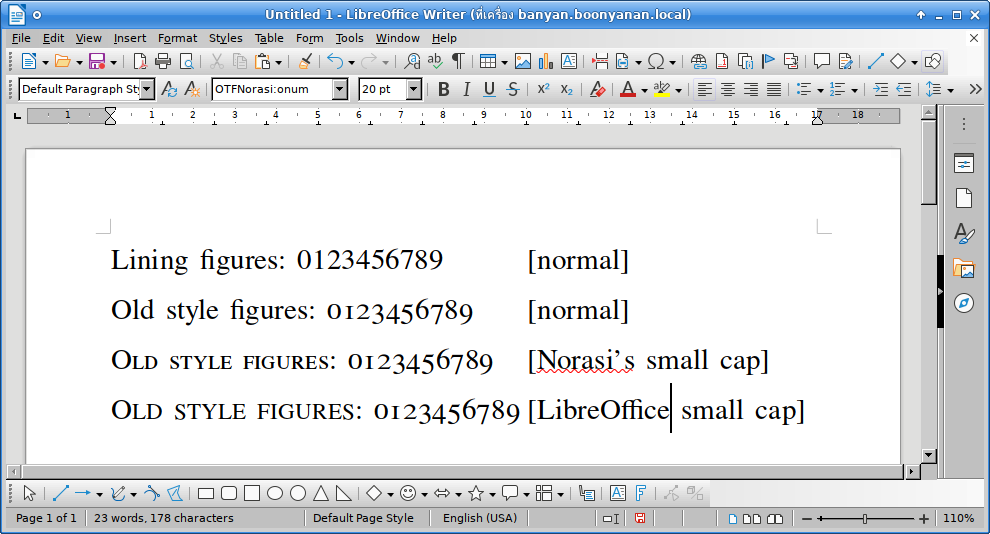
  • บรรทัดแรก เป็นตัวเลขแบบเรียงบนบรรทัด (lining figures)
  • บรรทัดที่ 2 เป็นตัวเลขแบบหนังสือยุคเก่า (old style figures)
  • บรรทัดที่ 3 เพิ่มการใช้ small caps จาก glyph ในฟอนต์เอง ผ่าน scmp โดยเลือกฟีเจอร์ Lower case to small capitals ใน character format
  • บรรทัดที่ 4 ใช้ Small capitals จาก text format ของ LibreOffice เอง ซึ่งน่าจะเป็นการสังเคราะห์ small caps ด้วยการย่อส่วนจากตัว capital ปกติ ซึ่งทำให้ได้เส้นที่บางลง และ LibreOffice ก็ได้พยายามลดผลกระทบนี้ด้วยการย่อส่วนแต่เพียงเล็กน้อย ทำให้ได้ตัว small caps ที่ยังสูงกว่าตัว lower case อยู่

สำหรับการใช้ในเว็บ ผมได้ลองทำ หน้าทดสอบ โดยใช้ font-variant: small-caps และ font-variant-numeric: oldstyle-nums ใน CSS

LaTeX

สำหรับผู้ใช้ XeLaTeX และ LuaLaTeX ก็สามารถใช้ OpenType feature ได้โดยตรง แต่สำหรับ pdfLaTeX ซึ่งยังใช้เทคโนโลยี PostScript ธรรมดา ก็จำเป็นต้องมีการรองรับเพิ่มเติมในแพกเกจฟอนต์

Small Caps

LaTeX2e รองรับ small caps ผ่านคำสั่ง \scshape และ \textsc{...} โดยตัว TeX engine จะไปหาการประกาศ sc shape ใน font description (lthnorasi.fd สำหรับฟอนต์ Norasi) เพื่อเชื่อมโยงไปหาไฟล์ TFM (TeX Font Metrics) ของ shape ดังกล่าว

และตรง TFM นี่แหละ ที่เราสามารถ remap อักขระ lower case ไปหา glyph ที่เป็น small caps ได้ ทำให้ TeX เรียงพิมพ์ตัว lower case ด้วยตัว small caps แทน

เท่ากับว่า จากฟอนต์ Norasi ที่เรามีอยู่แล้ว 6 type face (regular, slanted, italic, bold, bold slated, bold italic) เราจะต้องสร้าง face ใหม่อีกหนึ่งชุดที่ remap สำหรับ small caps กลายเป็น 12 type face

แต่เรายังมีรายละเอียดที่ต้องพิจารณาเพิ่มจากการ remap คือ:

  • ต้องตัดกฎ ligature สำหรับ ff, fi, fl, ffi, ffl ออกด้วย เนื่องจากรูป small caps ไม่มี ligature ดังกล่าว
  • ฟอนต์ไทยใช้กฎ ligature ในการจัดเรียงสระ-วรรณยุกต์ที่ไม่ลอยและหลบหางพยัญชนะ (shaping) ซึ่งยังจำเป็นต้องสร้างกฎเหล่านี้สำหรับ small caps อยู่

นั่นจึงนำไปสู่การสร้างไฟล์ .enc ต่างหากที่ remap small caps, ตัดกฎ Latin ligature, คงกฎ ligature สำหรับอักษรไทย พร้อมทั้งเขียน make rules สำหรับสร้าง TFM (สำหรับ TeX) และ VF (virtual font ซึ่งใช้ในขั้น dvi) สำหรับ small caps เพิ่มอีกชุดหนึ่งด้วย

สรุปรวมอยู่ใน GitHub commit นั่นแล

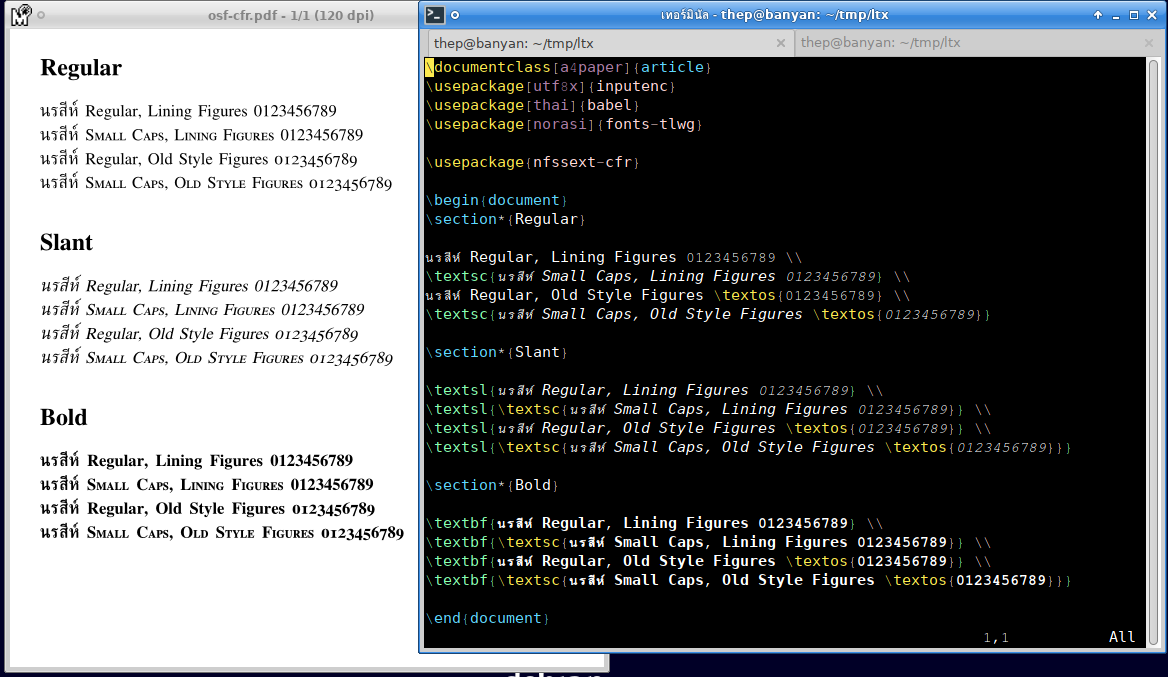
และเมื่อใช้งานผ่านคำสั่ง \textsc{...} ก็ได้ผลดังภาพ:
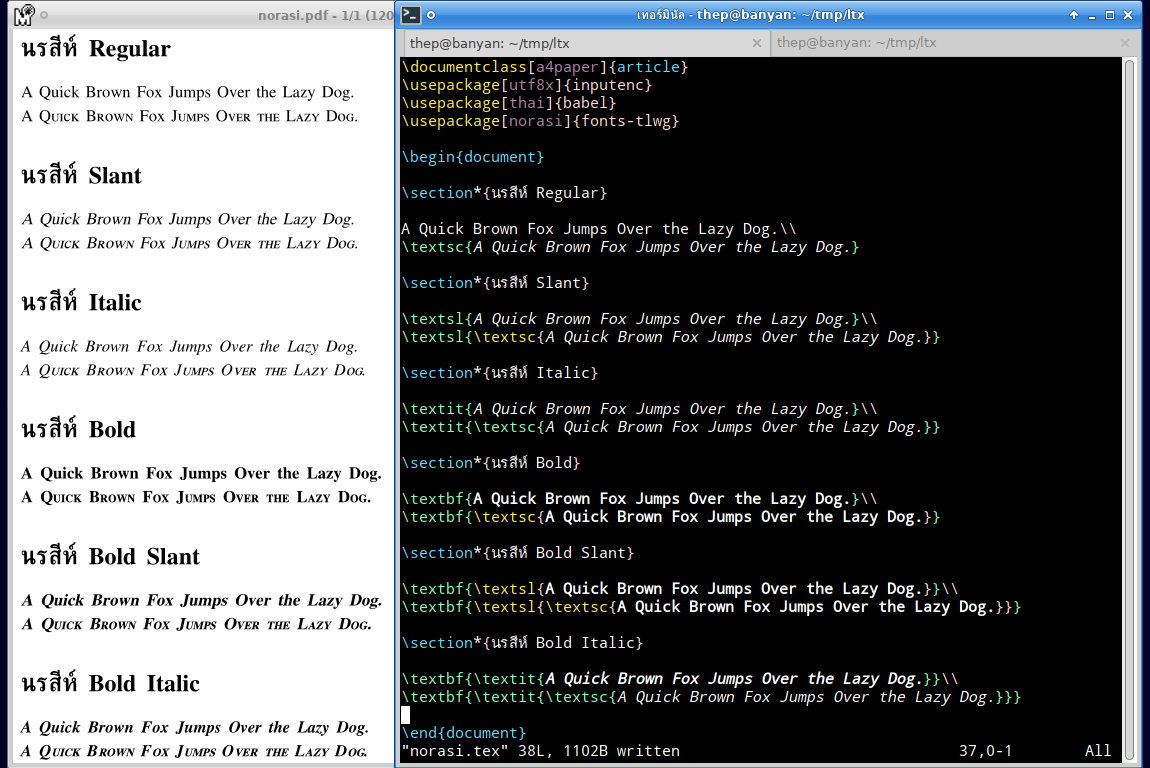
Small caps in pdfLaTeX

Old Style Figures

ด้วยเทคโนโลยี PostScript ธรรมดา การรองรับตัวเลขแบบหนังสือยุคเก่า (old style figures) ก็ยังคงต้องใช้วิธี remap อักขระตัวเลขไปเป็น PUA glyph ที่เป็น old style ไม่ต่างกับ small caps เพียงแต่ old style figures จะมีประเด็นการใช้งานในทางปฏิบัติที่ต้องพิจารณาเพิ่มเติมด้วย

LaTeX2e มีคำสั่ง \oldstylenums{ตัวเลข) เพื่อแสดง ตัวเลข เป็นแบบ old style ได้ โดยจะใช้ glyph จากฟอนต์ของ Knuth เสมอ แต่ในกรณีที่ต้องการให้ผู้ใช้สามารถใช้ตัวเลข old style จากฟอนต์ของเราได้ ก็จะต้องใช้ช่องทางอื่น

use case ที่น่าจะพบบ่อยในชีวิตจริง คือการใช้ตัวเลข old style ทั้งเอกสาร ทั้งเลขบท เลขหัวข้อ เลขหน้า เลขในข้อความ ฯลฯ ซึ่งตรงนี้จะต่างจาก small caps และแพกเกจฟอนต์มักจะรองรับในรูปของ option ของแพกเกจ

อีก use case หนึ่งคือการใช้ตัวเลข old style เฉพาะที่ ซึ่งมีแพกเกจอย่างน้อยสองตัวที่เตรียมคำสั่งไว้ให้ คือ nfssext-cfr และ fontaxes ซึ่งทั้งสองแพกเกจจัดเตรียมคำสั่งไว้คนละชุด ซึ่งก็ถือเป็นเรื่องปกติ แต่ที่ไม่ปกติคือทั้งสองแพกเกจเรียกใช้ฟอนต์ต่างกันด้วย!

old style figures ไม่ได้ถูกจัดให้เป็น shape หนึ่งของฟอนต์เหมือน small caps เพราะมันมีผลแค่กับตัวเลข ไม่ใช่ทั้งฟอนต์ วิธี implement จึงไม่ใช่การประกาศ shape ใน font description แต่เป็นการสร้าง font family ใหม่ไปเลย! โดยจะมีข้อตกลงบางอย่างในการตั้งชื่อ family ใหม่ที่ว่านั้น และเมื่อผนวกกับคุณสมบัติ proportional/tabular ของตัวเลขเข้าไปด้วยก็กลายเป็นข้อตกลงที่มีรายละเอียดอีกหน่อย

ปัญหาคือ แพกเกจ nfssext-cfr และ fontaxes ใช้ข้อตกลงคนละชุดกัน!

  • nfssext-cfr ใช้ font naming ของ Karl Berry ซึ่งออกแบบมาเพื่อแทนชื่อฟอนต์ให้ได้ใน 8 ตัวอักษร case-insensitive ซึ่งหมายถึงระบบแฟ้มของ DOS นั่นเอง โดยใน 8 ตัวอักษรจะแทนทั้งผู้ผลิต (foundry), ชื่อฟอนต์, ความหนา, variant (เช่น italic, oblique, sans serif, monospace, small caps, old style figures ฯลฯ), encoding, ความกว้าง, ขนาด ซึ่งน่าอัศจรรย์มากกับความพยายามบีบอัดขนาดนั้น แต่ดูไม่ practical เท่าไรกับโลกที่มีฟอนต์มากมายมหาศาล อีกทั้งระบบแฟ้มส่วนใหญ่ในปัจจุบันก็รองรับความยาวเกิน 8 ตัวอักษรกันแทบทั้งสิ้นแล้ว และจะว่าไป ชื่อฟอนต์บางชื่อที่ลงรหัสแบบนี้ก็ยาวเกิน 8 ตัวอักษรไปแล้วด้วย แต่อย่างไรก็ดี มันก็ยังถือเป็นข้อตกลงที่ใช้กันเป็นมาตรฐานของ LaTeX อยู่ และฟอนต์ Norasi ที่ใช้ old style figures ก็จะลงรหัสชื่อ font family (แบบไม่ได้ตรงหลักการเป๊ะ) ได้เป็น norj และ font family แบบปกติก็จะถูกย่อลงเป็น norx (ว่าตามนัยประวัติ ฟอนต์ Norasi ใน ThaiLaTeX ยุคเริ่มแรกก็เคยใช้ชื่อว่า nf3x ก่อนที่จะเปลี่ยนเป็น norasi ในภายหลัง)
  • fontaxes ใช้ข้อตกลงชื่อฟอนต์ของตัวเอง โดยปล่อยชื่อฟอนต์ให้ยาวตามปกติ แล้วเติมท้ายด้วยรหัส variant เช่น Norasi-OsF โดย variant ที่เกี่ยวกับตัวเลขได้แก่
    • OsF = old style figures
    • LF = lining figures
    • TOsF = tabular old style figures
    • TLF = tabular lining figures
    โดยที่ก็ยังรองรับ font naming ของ Karl Berry ด้วย เพียงแต่ไม่ได้บีบความยาวลงเท่านั้น ดังนั้น ตามข้อตกลงนี้ ฟอนต์ Norasi ที่ใช้ old style figures ก็จะใช้ชื่อ font family เป็น norasi-TOsF, norasi-OsF หรือ norasij ก็ได้ เพราะอันที่จริง ตัวเลขในฟอนต์ Norasi เป็น tabular อยู่แล้ว คือกว้างเท่ากันหมด เรียงตรงกันในตารางได้ แต่การใช้ norasi-TOsF จะใช้ได้กับการ mark up ตัวเลขเป็น tabular figures เท่านั้น ใช้ในข้อความธรรมดาไม่ได้ ส่วน norasi-OsF จะใช้ได้ในข้อความธรรมดาและการ mark up เป็น proportional figures เท่านั้น ใช้แบบ tabular ไม่ได้ แต่ norasij จะใช้ได้หมดทุกกรณี ดังนั้น ในกรณีของ Norasi จึงเลือกใช้ชื่อ norasij

จากหลักการทำงานและจากการทดลอง fontaxes ดูจะใช้ได้ในทางปฏิบัติมากกว่า จึงเลือกรองรับ fontaxes เป็นหลัก แต่ก็พยายามรองรับ nfssext-cfr ด้วยตามสมควร

จาก 12 type face ที่ได้จากการทำ small caps มาแล้ว เราก็จะสร้าง font family ใหม่ที่ประกอบด้วย 12 type face นี้ แต่ remap glyph ของตัวเลขไปเป็นแบบ old style เท่ากับว่าเราจะมีทั้งหมด 24 type face แบ่งเป็น 2 family, family ละ 12 type face

เมื่อเขียน make rules เพื่อสร้าง TFM/VF ของ 12 type face ฉบับ old style figures แล้ว เราก็สร้าง LTHnorasij.fd เพื่อประกาศ font family norasij

เพื่อการรองรับ nfssext-cfr เราก็สร้าง LTHnorj.fd ในทำนองเดียวกัน และสร้าง LTHnorx.fd ที่มีเนื้อหาหลักเหมือน LTHnorasi.fd ทุกประการด้วย

ทั้งหมดนี้ก็จะสามารถรองรับใช้ตัวเลขแบบ old style ผ่าน fontaxes และ nfssext-cfr (บางส่วน) ได้แล้ว
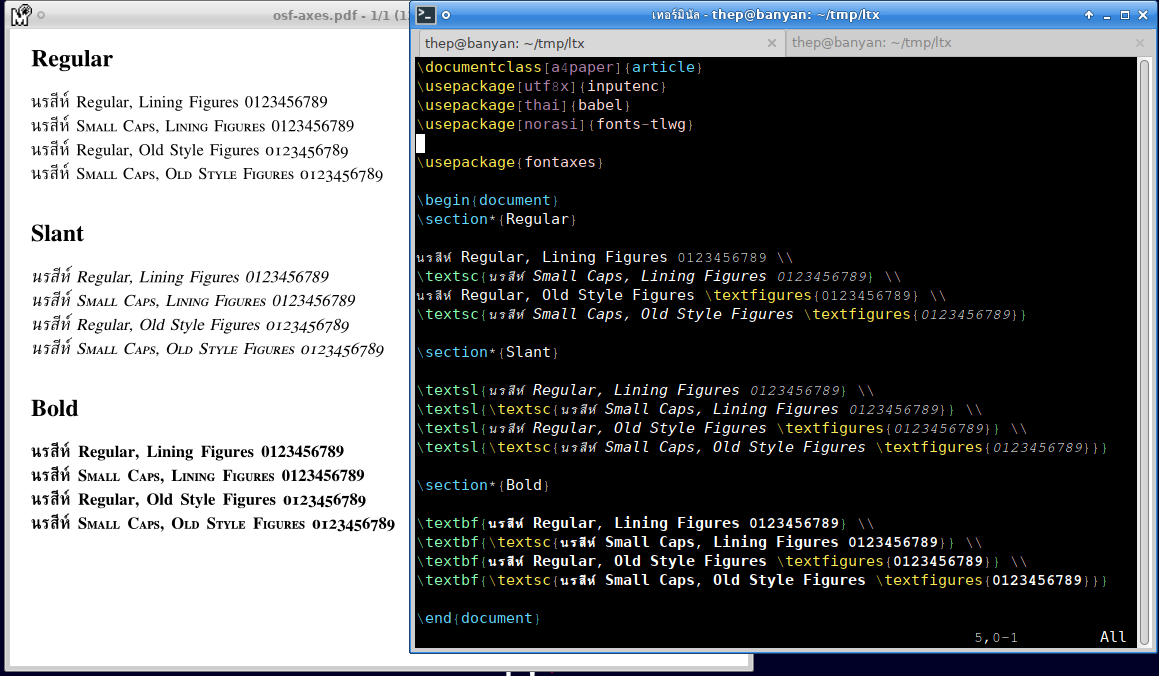
Old style figures via fontaxes

Old style figures via nfssext-cfr

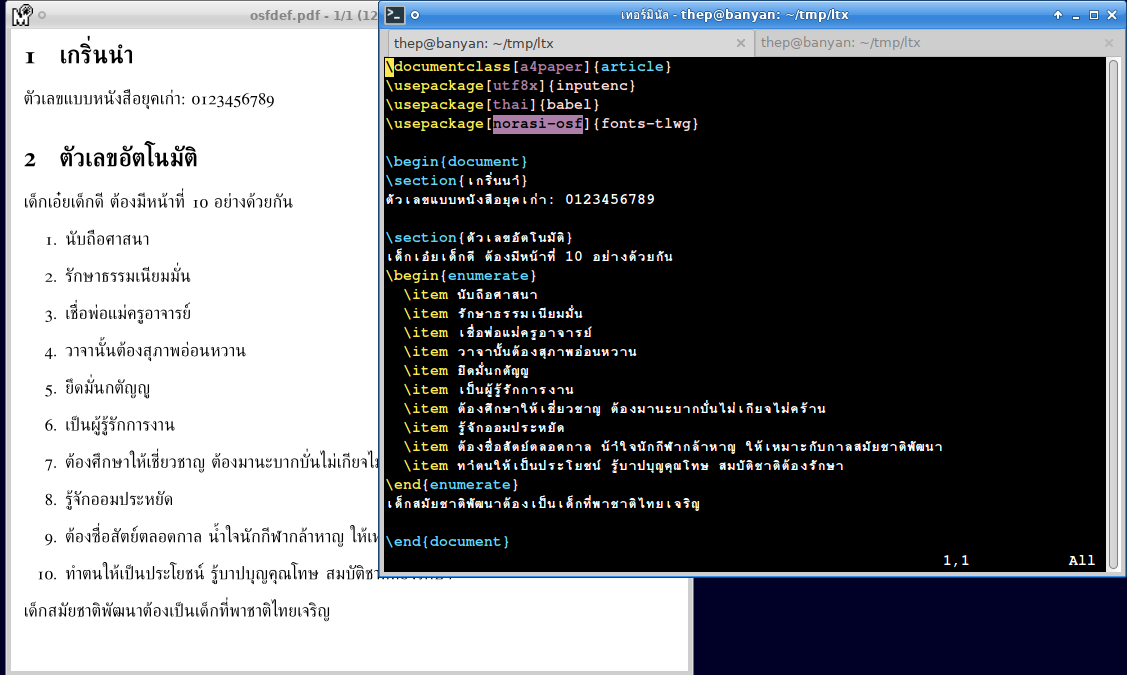
สำหรับ use case การใช้ตัวเลข old style ทั้งเอกสาร นั้น เราก็เพิ่ม option norasi-osf และ rmnorasi-osf ใน fonts-tlwg.sty โดยหากเลือกตัวเลือกนี้ก็จะกำหนดฟอนต์ปริยายเป็น norasij แทน norasi เท่านั้นเอง

Old style figures with 'norasi-osf' option

ทั้งหมดนี้อยู่ใน Git แล้ว มีตัวอย่างเอกสารในไดเรกทอรี latex/examples/ คือ:

  • oldnum.tex ใช้ตัวเลขแบบ old style ทั้งเอกสาร และใช้ small caps ในชื่อ section
  • digits-axes.tex ใช้ตัวเลขแบบ old style ผสมกับแบบ lining ผ่าน fontaxes พร้อมทั้งสาธิตการใช้ตัวเลขแบบ tabular/proportional ในตาราง
  • digits-cfr.tex ใช้ตัวเลขแบบ old style ผสมกับแบบ lining ผ่าน nfssext-cfr ซึ่งการใช้ตัวเลขแบบ tabular old style จะยังไม่ทำงาน

หลังจาก make install แล้ว สามารถใช้คำสั่ง make กับไฟล์ PDF ปลายทางได้เลย เช่น make oldnum.pdf

งานนี้สำเร็จลุล่วงได้ ขอให้เครดิตแก่พี่เลี้ยงที่มาช่วยดูแลพ่อ ทำให้ผมสามารถปลีกเวลามานั่งทำงานได้บ้าง

ป้ายกำกับ: , ,

23 สิงหาคม 2561

LibThai 0.1.28 and its Consequences

บันทึกการเปลี่ยนแปลงต่าง ๆ ที่มาใน LibThai 0.1.28 และผลพวงทั้งหลายหลังจากนั้น

LibThai 0.1.28 ออกไปตั้งแต่ต้นเดือน โดยรุ่นนี้มีรายการเปลี่ยนแปลงสำคัญ ๆ คือ:

  • แก้ปัญหาขาด header <thai/thwchar.h> ใน header ที่เกี่ยวกับฟังก์ชัน wide char หลาย ๆ ตัว เช่น thwbrk.h, thwcoll.h ฯลฯ ซึ่งเป็นปัญหาที่พบระหว่างเขียนโปรแกรมตัวหนึ่งที่เรียกใช้ libthai ทำให้ต้อง include thai/thwchar.h เอง ซึ่งไม่สะดวก ในรุ่นนี้สามารถ include header ที่ต้องการแล้วเรียกใช้งานได้เลย ไม่ต้องเพิ่ม include เองอีกแล้ว
  • ปรับโค้ดให้เป็นไปตาม C90 (ANSI C) มากขึ้น เป็นผลพวงจากที่ได้ทำกับ libdatrie 0.2.12 มาแล้ว
  • ปรับข้อมูลพจนานุกรมตัดคำ โดยในรุ่นนี้ได้รับความช่วยเหลือจากคุณ @nuttee15 จาก metamedia technology ที่ได้เสนอคำเพิ่มเข้ามาใน Issue #2 ที่เปิดไว้รับเสนอคำใหม่ในพจนานุกรมตัดคำ

จากนั้นก็ได้ upload debian package พร้อมความเปลี่ยนแปลงอย่างอื่น คือ เพิ่ม pkg-config ให้เป็น dependency ของ libthai-dev เพื่อให้แน่ใจว่า libthai.pc จะสามารถทำงานได้แม้ในระบบที่ติดตั้งแบบเล็กที่สุด (เป็นปัญหาที่พบระหว่างที่ทำงานชิ้นหนึ่งร่วมกับ metamedia technology) และ การรองรับการ build ที่ไม่ต้องใช้ (fake)root

รายการคำจากพจนานุกรมตัดคำของ libthai ก็ได้นำไปใช้ สร้าง hyphenation pattern ที่โครงการ thailatex ซึ่งขณะนี้กลายสภาพเป็นเพียงที่พักงานพัฒนา hyphenation pattern เท่านั้น จากนั้นจึงได้เสนอ pull request สำหรับ update hyphenation pattern สำหรับภาษาไทยในโครงการ TeX hyphenation patterns ซึ่งต้องรอการ merge เพื่อให้มีผลที่ต้นน้ำต่อไป

จาก TeX hyphenation pattern ก็ต้อง sync มายังเครื่องมือตัดคำสำหรับเอกสาร LaTeX ด้วย คือ swath ซึ่งนอกจากการปรับพจนานุกรมแล้ว ก็ได้ปรับโค้ดเล็ก ๆ น้อย ๆ ตามที่เคยทำในทุกรุ่นที่ผ่านมา โดยสิ่งที่ทำในรุ่นนี้คือ:

  • ทดลอง build โดยใช้ CFLAGS -Wall แล้วแก้ warning ต่าง ๆ
  • จากการแก้ warning ที่พบในโค้ดส่วน RTF filter ทำให้ตรวจพบความผิดปกติใน method หนึ่งที่ตัวฟังก์ชันทำงานตรงข้ามกับชื่อ คือ RTFToken::isEmpty()

    โค้ดส่วนจัดการ RTF นี้ ไม่ค่อยมีใครเรียกใช้ ความจริงผมเคยเสนอจะตัดทิ้งไปแล้ว แต่ด้วยความช่วยเหลือของคนในชุมชน (คุณวิทยา ไตรสารวัฒนะ) ทำให้ได้วิธีทดสอบความถูกต้องของโปรแกรม จึงยังคงเก็บไว้ แต่เนื่องจากเวลานั้น swath ยังไม่เริ่มทำ TDD จึงยังไม่ได้ใส่ test case ไว้ใน source tree

    เพื่อจะตรวจแก้ฟังก์ชันที่สงสัยนี้ ผมจึงต้องไปดึงเอกสารตัวอย่างมาจาก thread เก่าที่ว่า แล้วนำมา เพิ่ม test case เสียก่อน หากคุณสงสัยว่าทำไม source tarball ของ swath รุ่นนี้ถึงโตขึ้นจนผิดสังเกต มันก็มาจากเอกสาร RTF ทดสอบนี้นี่เอง

    จากนั้น จึงได้ แก้ฟังก์ชันที่สงสัย นั้น แล้วรัน test เปรียบเทียบ output ดูโดยใช้ LibreOffice ปรากฏว่าเป็นการแก้ที่ถูกต้องแล้ว เพราะมันทำให้ได้จุดตัดคำครบถ้วนสมบูรณ์ขึ้น

    ไม่ว่าจะมีใครใช้หรือไม่ก็ตาม แต่คอมไพเลอร์ยังคงคอมไพล์มันอยู่ และนำผมเข้ามาเจอและแก้บั๊กจนได้

  • แก้ warning อื่น ๆ และทำความสะอาดโค้ดเล็ก ๆ น้อย ๆ
  • สุดท้าย มี pull request ของคุณ @pepa65 ที่เสนอไว้นานแล้ว เพื่อร่างแฟ้ม INSTALL ที่อธิบายความแตกต่างของวิธี build swath จาก git กับจาก released tarball ซึ่งผมก็เห็นว่ามีประโยชน์กว่าแฟ้ม INSTALL ที่ GNU automake มันเติมให้แบบอัตโนมัติ จึง merge เข้ามาเสีย

แล้วก็ออกรุ่น swath 0.6.1 ตามมาด้วย Debian upload ซึ่งก่อนอัปโหลดก็ได้ปรับ branch layout ของ swath packaging ตาม DEP-14 ด้วย

ป้ายกำกับ: , ,

25 เมษายน 2561

Fonts-TLWG 0.6.5

Fonts-TLWG 0.6.5 ออกแล้ว โดยมีความเปลี่ยนแปลงที่สำคัญคือการแก้บั๊กของฟอนต์ Laksaman เมื่อใช้กับเอกสาร LaTeX โดยผมได้รับรายงานปัญหานี้จาก อ. กิตติพิชญ์ มีสวาสดิ์ ในการประชุม โสเหล่ ของ KKLUG เมื่อเดือนมีนาคมที่ผ่านมา

อาการคือ คำที่มี ff, ffi, ffl จะไม่มี ligature สามชุดนี้ปรากฏ ผมสร้างเอกสารทดสอบ โดยในข้อความแต่ละชุด บรรทัดแรกจะป้อนข้อความปกติ ส่วนบรรทัดที่สองจะเลี่ยง ligature:

if iff film flow difficult affluent

if if{}f f{}ilm f{}low dif{}f{}icult af{}f{}luent

ผลลัพธ์คือ:

Laksaman bug on LaTeX

สังเกต ligature ที่หายไปในบรรทัดแรกของข้อความแต่ละชุด

ในฟอนต์ต้นทาง คือ TH Sarabun New นั้น มี ligature ของละตินมาให้เพียงสองตัว คือ fi และ fl แต่ในกฎ LIGKERN ของ TeX จะใช้ทั้งหมด 5 ตัว โดยอีก 3 ตัวที่ยังขาดคือ ff ffi และ ffl เมื่อสร้าง glyph ทั้งสามตัวเพิ่มเข้าไปก็จะได้ผลลัพธ์ที่ควรจะเป็น:

Laksaman fixed for LaTeX

ผลข้างเคียงก็คือ ฟอนต์ Laksaman เมื่อใช้บนเดสก์ท็อปหรือบนเว็บจะมี ligature ครบกว่า TH Sarabun New ซึ่งความแตกต่างนี้ต้องสังเกตใกล้ ๆ อย่างละเอียดพอสมควร

ก่อนแก้:

Laksaman on Firefox, before

หลังแก้:

Laksaman on Firefox, after

ขอขอบคุณ อ. กิตติพิชญ์ ผู้ใช้ LaTeX ตัวจริงคนหนึ่งมา ณ ที่นี้ ที่จับบั๊กนี้ได้ครับ

นอกจากนี้ยังมีความเปลี่ยนแปลงอื่น ๆ คือ:

  • แปลงแฟ้มต้นฉบับของฟอนต์เป็นฟอร์แมตของ Fontforge รุ่นล่าสุด
  • ปรับ configure script ให้ตรวจรุ่นของ fontforge ตามรูปแบบเลขรุ่นที่เปลี่ยนไป จากแบบตัวเลขมาเป็นแบบวันที่
  • ย้ายที่ติดตั้งแฟ้ม fontconfig template ทั้งหลาย จาก /etc/fonts ไปไว้ที่ /usr/share/fontconfig ตามการเปลี่ยนแปลงใน fontconfig ล่าสุด
  • ปรับค่า TTFWeight ของฟอนต์น้ำหนักปกติทุกฟอนต์ให้เป็นค่า 400 (Regular) ทั้งหมด เนื่องจากบางฟอนต์ที่ยังมีค่าเป็น 500 (Medium) นั้น ทำให้แอปบางตัว (เช่นที่รายงานใน Issue #5 คือ EditPad) จัดฟอนต์ให้ไปอยู่ในกลุ่มตัวหนา

ได้อัปโหลดฟอนต์รุ่นใหม่ขึ้น CTAN ไว้แล้ว รอสักระยะถึงจะมาถึงดิสโทรต่าง ๆ เพื่อให้ใช้กับเอกสาร LaTeX ได้

ส่วนบนเดสก์ท็อปนั้น ก็ได้อัปโหลด 1:0.6.5-1 เข้า Debian เรียบร้อยแล้วครับ

ป้ายกำกับ: ,

20 ตุลาคม 2560

Fonts-SIPA-Arundina 0.2.2

Fonts-SIPA-Arundina 0.2.2 ออกแล้ว รุ่นนี้ปรับปรุงความสามารถของ LaTeX package โดยดึงมาจาก Fonts-TLWG 0.6.4 สองเรื่อง คือ

  • ตัวเลือก sans เพื่อกำหนดให้ใช้ฟอนต์ sans-serif เป็นฟอนต์ปริยายของเอกสาร
  • ตัวเลือก scale=value เพื่อกำหนดอัตราย่อ-ขยายของตัวอักษร

นอกจากนี้ ยังมีรายการเปลี่ยนแปลงเล็กน้อยเกี่ยวกับ CTAN คือผมพยายามจะเปลี่ยนชื่อแพกเกจจาก fonts-sipa-arundina ให้เป็น fonts-arundina เพื่อความกระชับในการเรียก โดยได้ทำไปแล้วสองส่วน คือ ชื่อโครงการที่ GitHub และในชื่อแพกเกจ LaTeX ซึ่งผู้ใช้สามารถเรียกใช้ด้วยคำสั่ง \usepackage{fonts-arundina} ได้

ส่วนที่ทำเพิ่มในรุ่นนี้ก็คือ การเปลี่ยนชื่อไดเรกทอรีที่ CTAN จาก /fonts/thai/fonts-sipa-arundina ให้เป็น /fonts/thai/fonts-arundina เฉย ๆ เพื่อให้สอดคล้องกับชื่อแพกเกจจริง รวมทั้งเปลี่ยนชื่อ source directory ใน CTAN ZIP file ด้วย

ส่วนที่ยังเหลือ คือ ชื่อ Debian package และ ชื่อ FTP directory ที่ LTN ซึ่งทั้งสองส่วนยังเกี่ยวพันกันอยู่ และการเปลี่ยนชื่อแพกเกจใน Debian จะมีรายละเอียดให้ทำพอสมควร เช่น การรอคิว NEW, การทำ package transition, การ clean config file เก่า ฯลฯ จึงยังคงชะลอไว้ก่อน จนกว่าจะมีเวลาเป็นเรื่องเป็นราวกว่านี้

เนื่องจาก LaTeX package ของฟอนต์ Arundina ยังไม่ได้เป็นส่วนหนึ่งของ TeXLive เหมือนกับชุด fonts-tlwg และเสิร์ฟให้ผู้ใช้ Debian ผ่านแพกเกจ latex-fonts-sipa-arundina โดยตรง ผู้ใช้ LaTeX ผ่าน Debian unstable จึงสามารถอัปเกรดและทดลองใช้ได้ทันที

ป้ายกำกับ: ,

06 ตุลาคม 2560

Fonts-TLWG 0.6.4

Fonts-TLWG 0.6.4 ออกแล้วเมื่อวันก่อน โดยรุ่นนี้เป็นผลงานของคุณ Abhabongse Janthong ที่ได้รายงานบั๊ก 1 รายการ และขอเพิ่มฟีเจอร์อีก 1 รายการ ซึ่งเป็นเรื่องเกี่ยวกับ LaTeX ทั้งสองรายการ

Issue #1 เป็นปัญหาความไม่สมบูรณ์ของการกำหนดตระกูลฟอนต์เมื่อสลับภาษาใน Babel ทำให้คำสั่ง \normalfont ทำงานผิดพลาดเมื่อใช้ร่วมกับตัวเลือก sans ของแพกเกจ ซึ่งคุณ Abhabongse ก็ได้เสนอ Pull Request #2 เพื่อแก้ปัญหานี้

กล่าวคือ รุ่นนี้จะแก้ปัญหากรณีเช่นนี้:

\usepackage[sans]{fonts-tlwg}

...

ข้อความก่อน \normalfont ข้อความหลัง

ทั้ง ข้อความก่อน และ ข้อความหลัง ควรเป็นฟอนต์ sans-serif ทั้งคู่ ซึ่งรุ่นก่อนหน้านี้จะจัด ข้อความหลัง ด้วยฟอนต์ serif ซึ่งไม่ถูกต้อง

ส่วนอีกรายการหนึ่งคือ Pull Request #3 เพื่อเพิ่มตัวเลือก scale สำหรับกำหนดอัตราย่อ-ขยายของตัวอักษรตามต้องการ ซึ่งจะเป็นประโยชน์ในกรณีที่ใช้ฟอนต์ชุดนี้ร่วมกับภาษาอื่นที่ฟอนต์ขนาดไม่สมส่วนกัน กล่าวคือ ในรุ่นนี้ ผู้ใช้จะสามารถใช้ตัวเลือกเช่นนี้เพื่อขยายขนาดตัวอักษรขึ้น 30% :

\usepackage[scale=1.3]{fonts-tlwg}

เนื่องจากในรุ่นนี้ไม่มีความเปลี่ยนแปลงในเนื้อหาส่วนอื่นอีกนอกจากการรองรับ LaTeX ผู้ใช้จะได้พบสิ่งที่เปลี่ยนแปลง ก็จากแพกเกจ fonts-tlwg บน CTAN เท่านั้น ส่วน Debian upload นั้น ก็เป็นไปตามภาคบังคับเพื่ออัปเดตรุ่นและซอร์สโค้ด ผู้ใช้ Debian สามารถติดตามได้จากแพกเกจ texlive-lang-other ว่าจะดึง fonts-tlwg ตัวใหม่จาก CTAN มาเสิร์ฟเมื่อไร

สุดท้ายนี้ ขอขอบคุณคุณ Abhabongse Janthong สำหรับความคืบหน้าที่เกิดขึ้นในรุ่นนี้ครับ

ป้ายกำกับ: ,

25 พฤศจิกายน 2557

FOSS Behind my Wedding

blog นี้เป็น blog แรกที่ผมเขียนภายใต้สถานภาพ สมรส หลังจากที่ได้เข้าพิธีแต่งงานไปเมื่อวันที่ 26 ต.ค. ที่ผ่านมา (นับถึงวันที่ 25 พ.ย. ที่เขียน blog นี้ ก็ครบ 30 วันพอดี)

ชีวิตผมซึ่งอยู่กับ ซอฟต์แวร์เสรี และ โอเพนซอร์ส อยู่แล้ว ก็เป็นธรรมดาที่จะมีสิ่งนี้เข้ามาพัวพันกับงานครั้งนี้

วีดิทัศน์

เริ่มจากการเตรียมวีดิทัศน์แนะนำตัวบ่าว-สาว ผมกับเจ้าสาวช่วยกันคัดรูปถ่ายของพวกเราตั้งแต่วัยเด็กจนโต แล้วนำมาสร้างเป็นวีดิทัศน์เล่นภาพสไลด์พร้อมเพลงประกอบ

เครื่องมือแรกที่ใช้คือ dvd-slideshow ซึ่งเป็นชุด command-line สำหรับสร้างวีดิทัศน์จากแฟ้ม spec ซึ่งเป็น text file แต่ติดปัญหาว่ามันมี error message และ gen video ไม่สำเร็จ จึงได้ file Debian #750626 พร้อมเสนอแพตช์แก้ ซึ่งเริ่มมีผลในรุ่น 0.8.4.2-3 ของ Debian

นั่นเป็นการทดลองเครื่องมือก่อน แต่เมื่อเริ่มได้รูปภาพจำนวนหนึ่งมา การจะนั่งจัดเรียงภาพด้วยการ edit text file พร้อมกับเจ้าสาวซึ่งไม่ใช่นักคอมพิวเตอร์ มันก็ลำบากอยู่ จึงได้ไปหาเครื่องมือตัวอื่น จนกระทั่งพบ imagination ซึ่งเป็น GUI โดยใช้ GTK+ 2.0 ซึ่งทำให้สามารถลากจัดลำดับรูปภาพได้ พร้อมกับมี transition ที่หลากหลายกว่า

ปัญหาเกิดขึ้นเมื่อจะ gen video กลับ gen ไม่ได้ เพราะหา FFmpeg ไม่เจอ เนื่องจาก FFmpeg ได้ถูกตัดออกจาก Debian ไปแล้ว จึงได้ไปค้นบั๊กของ Debian พบ Debian #722293 ซึ่งมีผู้รายงานไว้ และได้ forward bug ไปที่ต้นน้ำ (Imagination #78) จึงตามไปคุยและเสนอแพตช์ที่ต้นน้ำ พร้อมกลับมาแปะแพตช์ไว้ที่ Debian ด้วย

ผู้พัฒนาต้นน้ำดูจะไม่กระตือรือร้นสักเท่าไรกับแพตช์ที่เสนอ หลังจากตรวจสอบไปก็พบว่า FFmpeg ยังไม่ตาย ไม่ได้เปลี่ยนชื่อเป็น libav อย่างที่ผู้ดูแลแพกเกจใน Debian และ Ubuntu พยายามจะสื่อถึงผู้ใช้ แต่ libav เป็น fork หนึ่งของ FFmpeg ซึ่งทีม Debian เลือกมาใช้แทน แต่ในดิสโทรอื่นยังคงใช้กันอยู่ และผู้ใช้ Debian/Ubuntu บางส่วนก็ต้องการกลับไปใช้ FFmpeg เหมือนเดิม (อ่าน ตัวอย่างเรื่องเล่าสถานการณ์) และมีนักพัฒนา Debian เสนอกลับเข้ามาใหม่ จนกระทั่ง ได้เข้า experimental และ sid ในที่สุด (แต่ไม่ทัน Jessie freeze จึงไม่มีใน Jessie)

อย่างไรก็ดี ในขณะที่ผมทำวีดิทัศน์ของผมอยู่นั้น Debian ไม่มี FFmpeg ทั้งใน testing และ unstable จึงได้ผลักดันแพตช์ให้ imagination กลับมาทำงานได้ โดยเพิ่มระดับความรุนแรงของ Debian #722293 จาก important เป็น grave เพื่อให้มันกลายเป็น RC bug เพราะถึงอย่างไร FFmpeg ก็จะไม่มีใน Jessie ถ้า Debian จะออก Jessie พร้อมกับ imagination ที่ต้องการ FFmpeg มันก็จะไม่สามารถ gen video ได้เลย จนในที่สุด แพตช์ก็เริ่มมีผลในรุ่น 3.0-5 ของ Debian ส่วนที่ต้นน้ำนั้น ผมเข้าใจแล้วว่าบั๊กนี้ไม่ถือว่ารุนแรงนอก Debian/Ubuntu

เป็นอันว่า กว่าผมจะเริ่มทำวีดิทัศน์ได้ ก็ได้แก้ RC bug ใน Debian ไปแล้ว 2 bug และสามารถสร้างวีดิทัศน์ได้ตามที่ต้องการ

พิมพ์ซอง

ตัวการ์ดเชิญนั้น แน่นอนว่าผมพิมพ์เองไม่ได้ ก็สั่งร้านพิมพ์ให้ แต่การพิมพ์ชื่อแขกที่จะเชิญลงที่หน้าซองนั้น จำเป็นต้องทำระบบให้เป็นอัตโนมัติสักหน่อย

ผมเริ่มจากเขียน shell script เอง โดยอ่านรายชื่อจาก text file มาสร้างแฟ้ม LaTeX ก่อนคอมไพล์เป็น PDF ทีละราย แต่นั่นทำให้จำนวนไฟล์เยอะมาก PDF 1 แฟ้มต่อแขก 1 คน

ผมจึงมองหาวิธีทำ mail merge ใน LaTeX ดู ก็พบแพกเกจ mailmerge แต่ปรากฏว่าต้องใส่รายชื่อใน LaTeX source เลย แทนที่จะแยกออกมาข้างนอกต่างหาก กลายเป็นว่า PDF ไฟล์เดียวมีซองของแขกทุกคน ทำให้เพิ่มแขกที่จะเชิญทีละกลุ่มได้ลำบาก (คุณนึกออกไหม? เวลาที่นึกได้ว่าควรเชิญญาติคนนั้นเพิ่ม เพื่อนคนนู้นทวงการ์ดเชิญ เพื่อนที่ได้การ์ดแนะนำว่าควรเชิญคนนั้นคนนี้เพิ่มอีก ฯลฯ ผมจึงต้องเตรียมพร้อมที่จะพิมพ์ซองเพิ่มได้ตลอดเวลา)

จนกระทั่งพบแพกเกจ textmerg ที่ตอบโจทย์ของผม เพราะสามารถทำ master file ของซองเอาไว้ แล้วจัดการรายชื่อแขกในแฟ้มภายนอกต่างหาก จากนั้นสั่งคอมไพล์และจัดพิมพ์ซองทีละกลุ่ม หนึ่งกลุ่มหนึ่งไฟล์ ทำให้จำนวนไฟล์ไม่เยอะเกินไป และสามารถคัดแยกได้สะดวก ว่ากลุ่มไหนพิมพ์ซองไปบ้างแล้ว กลุ่มไหนยังไม่พิมพ์

สำหรับ LaTeX ไม่พบบั๊กอะไรครับ ใช้งานได้ราบรื่นดี รายละเอียดการใช้งานสามารถศึกษาจากเอกสารของแพกเกจได้ไม่ยาก (บน Debian ก็แค่สั่ง texdoc ชื่อแพกเกจ บนเทอร์มินัล) หรือถ้ามีเวลา ผมอาจจะเขียนวิธีการในภายหลัง

นั่นคือการใช้ FOSS ในการเตรียมงานแต่งงานของผมครับ ผ่านมาได้ด้วยดี ก็บันทึกไว้เป็นกรณีศึกษาเสียหน่อย :-)

ป้ายกำกับ: , , ,

02 กันยายน 2557

swath 0.5.3

swath 0.5.3 ออกแล้วเมื่อวานนี้ รุ่นนี้เป็นการปรับพจนานุกรมตามหลัง การอัปเดต TeX hyphenation pattern ซึ่งปรับตามพจนานุกรมของ LibThai 0.1.21 อีกทอดหนึ่ง แต่พร้อมกันนี้ก็มีการเปลี่ยนแปลงอย่างอื่นที่น่าสนใจด้วย

คุณ +Sorawee Porncharoenwase รายงานมาใน Google+ ส่วนตัวว่าพบบั๊ก 2 ตัวใน swath เมื่อใช้งานกับ plain text:

  • เมื่อป้อนข้อความ UTF-8 ยาว ๆ ผ่านคำสั่ง swath -u u,u ปรากฏว่าข้อความจะถูกตัดท้ายก่อนจบ
  • swath ทะลึ่งไปแทรกรหัสตัดคำในภาษาอังกฤษและหลังเครื่องหมายวรรคตอนบางตัวในโซนภาษาไทยด้วย เช่น:
    hello (|world)
    สวัสดี (|ครับ|)
    

บั๊กแรกนั้น ความจริง swath จองที่ไว้สำหรับบรรทัดยาวถึง 2000 อักขระ ซึ่งข้อความตัวอย่างที่คุณ Sorawee ให้มาก็ไม่ได้เกินนั้น เมื่อตรวจสอบก็พบว่ามาจากโค้ดส่วนอ่าน-เขียน UTF-8 ที่จองบัฟเฟอร์ไว้รองรับแค่ 1 ไบต์ต่ออักขระ ในขณะที่ UTF-8 ต้องการถึง 6 ไบต์ต่ออักขระใน extreme case จึงได้จองเนื้อที่ไว้ให้เพียงพอ ก็แก้ปัญหาได้

บั๊กที่สอง มีวิธีแก้ได้สองวิธี คือเข้าไปล้วงในอัลกอริทึมตัดคำระดับล่างของ swath เลย หรือแก้ที่ตัวอ่าน token เพื่อให้ส่งเฉพาะภาษาไทยเข้าสู่อัลกอริทึมตัดคำเท่านั้น ผมเลือกอย่างหลัง ด้วยเหตุผลสองประการ:

  1. โค้ดระดับล่างของ swath นั้น เป็นโค้ดที่คนเขียน (ซึ่งไม่ใช่ผม) อ่านรู้เรื่องคนเดียว และไม่ได้ออกแบบให้รองรับการปรับเปลี่ยนอะไรมากนัก การเข้าไปแตะโค้ดส่วนนี้จึงเสี่ยงเกินไป
  2. ใน file filter ทั้งหลาย ทั้งสำหรับ LaTeX, HTML และ RTF ต่างก็ใช้วิธีส่งเฉพาะ token ภาษาไทยไปให้อัลกอริทึมตัดคำทั้งนั้น ในขณะที่ส่วนจัดการ plain text กลับส่งเข้าไปทั้งก้อนโดยไม่แยก การแก้ส่วนจัดการ plain text ให้ทำงานแบบเดียวกันจึงดูสมเหตุสมผล

และก่อนที่จะออก swath ในแต่ละรุ่น ผมพยายามจะทำความสะอาดโค้ดไปทีละนิด สำหรับรุ่นนี้ สิ่งที่ทำคือตัดโค้ดที่ไม่ได้ใช้งานทิ้ง ได้แก่โค้ดส่วนทำ shaping ภาษาไทยใน LaTeX filter ซึ่งไม่มีการเรียกใช้มานานมากแล้ว ตั้งแต่มี thailatex (ซึ่งปัจจุบันคือ babel-thai ใน CTAN) ที่รองรับการทำ shaping ผ่าน virtual font มาตั้งแต่ต้น เมื่อตัดโค้ดส่วนนี้ไป ก็ทำให้ขนาดของโปรแกรมที่ strip แล้วลดลงประมาณ 4 KiB

นอกจากนี้ ก็ได้ปรับข้อความใน man page นิดหน่อยด้วย หลังจากที่ thailatex เปลี่ยนเป็น babel-thai มาระยะหนึ่งแล้ว (ประกาศเมื่อปีกลาย) ก็กล่าวถึง babel-thai ให้เหมาะสม

อัปโหลดเข้า Debian Sid แล้วครับ คุณควรจะเจอแพกเกจใหม่ตั้งแต่เมื่อเช้าแล้วแหละ

ป้ายกำกับ: ,

08 กรกฎาคม 2557

Fonts-TLWG 0.6.1

Fonts-TLWG 0.6.1 ออกไปแล้วเมื่อวานนี้ สรุปความเปลี่ยนแปลงในรุ่นนี้คือ:

  • ฟอนต์ใหม่: ลักษมัณ (Laksaman) ซึ่งดัดแปลงจากฟอนต์ TH Sarabun New ของคุณศุภกิจ เฉลิมลาภ และ SIPA
  • แตกแฟ้ม fontconfig จากแฟ้มเดี่ยวๆ เป็นแฟ้มย่อย เพื่อให้สามารถเลือกติดตั้งฟอนต์เพียงบางส่วนได้ ซึ่งเป็นสิ่งที่ดัดแปลงไว้ในแพกเกจของ Debian ก็เพียงแต่ merge เข้ามาที่ต้นน้ำเท่านั้น
  • Option ใหม่สำหรับ LaTeX เพื่อให้สามารถกำหนดฟอนต์ปริยายของเอกสารได้โดยสะดวก

มีผลข้างเคียงอีกเรื่องหนึ่งที่ไม่ได้กล่าวไว้ใน blog ก่อน ๆ คือเรื่องการตัดการวาด ฤา เป็น ฤๅ ของฟอนต์สารบรรณออกในฟอนต์ลักษมัณ ซึ่งการวาดดังกล่าวผมถือว่าผิดหลักการ เพราะสตริงทั้งสองถือว่าเป็นสตริงที่ต่างกันทั้งในรหัส มอก.620-2533 และในยูนิโค้ด ผู้ใช้ควรสามารถแยกความแตกต่างได้ว่าเป็นสตริงที่ต่างกัน

พฤติกรรมนี้อาจมาจากการพยายามแก้การพิมพ์ผิดอย่างกลาดเกลื่อนของผู้ใช้ทั่วไป ที่มักจะพิมพ์ ฤๅ และ ฦๅ โดยใช้สระอาแทนลากข้างยาว แต่การแก้ที่ฟอนต์ถือว่าไม่ถูกต้อง เพราะเป็นการอำพรางความแตกต่างของข้อมูลจริง หากจะแก้ปัญหาให้ถูก ควรแก้ที่ input method ซึ่งประเด็นที่คล้ายกันนี้ผมเคยเขียนถึงไปแล้วใน กรณีฟอนต์ Sarabun IT9 การแก้ปัญหาที่ฟอนต์จะยิ่งเป็นการส่งเสริมการป้อนข้อมูลที่ผิดให้กว้างขวางยิ่งขึ้น ดังนั้นผมจึงตัดกฎข้อนี้ออกในฟอนต์ลักษมัณ และถ้าเป็นไปได้ก็อยากให้แก้ในฟอนต์มาตรฐานราชการไทยทั้ง 13 ฟอนต์ด้วย

ได้อัปโหลด Debian package เข้า sid ไปแล้ว แต่ยังรออยู่ในคิว NEW เนื่องจากมีแพกเกจใหม่ของฟอนต์ลักษมัณเพิ่มเข้ามา พร้อมกันนี้ก็ได้อัปโหลดแพกเกจ LaTeX ไปที่ CTAN แล้วด้วย ผู้ใช้ TeXLive ก็รอพบได้จากแพกเกจ texlive-lang-other รุ่นถัดไปครับ

ป้ายกำกับ: , ,

05 กรกฎาคม 2557

LaTeX Options for fonts-tlwg

การเพิ่มฟอนต์ลักษมัณในแพกเกจ Fonts-TLWG พร้อมกับรองรับใน LaTeX ด้วยนั้น ทำให้เกิดคำถามกับผมว่า ในเมื่อมีฟอนต์สองค่ายมาอยู่ด้วยกัน คือ ฟอนต์แห่งชาติของเนคเทค และ ฟอนต์มาตรฐานราชการไทย จากกรมทรัพย์สินทางปัญญาร่วมกับ SIPA (เว็บต้นทาง สาบสูญไปแล้วตามระเบียบของราชการไทย) ย่อมจะเกิดทางเลือกการใช้ฟอนต์ที่เด่นชัดระหว่างสองค่ายนี้ ซึ่งผู้ใช้อาจเลือกฟอนต์ได้โดยใช้คำสั่งใน preamble เช่น เมื่อต้องการใช้ฟอนต์ลักษมัณในเอกสาร:

\renewcommand{\sffamily}{laksaman}
\AtBeginDocument{\sffamily}

แต่ด้วยแนวโน้มของความต้องการที่น่าจะสูงพอ ผมจึงตัดสินใจเพิ่ม option ให้กับแพกเกจ fonts-tlwg เสียเลย โดยผู้ใช้สามารถใส่ option ขณะ \usepackage ได้เลย โดยแบ่งหมวดหมู่ของ option ดังนี้:

  • การใช้ฟอนต์ sans-serif แทนค่าปกติที่เป็นฟอนต์ roman:
    • sans : ใช้ฟอนต์ sans-serif เป็นฟอนต์ปกติของเอกสาร
  • การกำหนดฟอนต์ roman, sans-serif, และ teletype ของเอกสาร:
    • rmkinnari : ให้ฟอนต์ kinnari เป็นฟอนต์ roman ปริยาย
    • rmnorasi : ให้ฟอนต์ norasi เป็นฟอนต์ roman ปริยาย
    • sfgaruda : ให้ฟอนต์ garuda เป็นฟอนต์ sans-serif ปริยาย
    • sflaksaman : ให้ฟอนต์ laksaman เป็นฟอนต์ sans-serif ปริยาย
    • sfumpush : ให้ฟอนต์ umpush เป็นฟอนต์ sans-serif ปริยาย
    • sfloma : ให้ฟอนต์ loma เป็นฟอนต์ sans-serif ปริยาย
    • sfwaree : ให้ฟอนต์ waree เป็นฟอนต์ sans-serif ปริยาย
    • ttttype : ให้ฟอนต์ ttype เป็นฟอนต์ teletype ปริยาย
    • ttttypist : ให้ฟอนต์ ttypist เป็นฟอนต์ teletype ปริยาย
    ตัวเลือกกลุ่มนี้ไม่ได้เปลี่ยนฟอนต์ปริยายของเอกสารโดยตรง แต่เปลี่ยนฟอนต์ทั้งสามตระกูลสำหรับใช้คละกันในเอกสาร
  • การกำหนดฟอนต์ปริยายของเอกสาร:
    • kinnari : ให้ฟอนต์ kinnari เป็นฟอนต์ปริยายของเอกสาร
    • garuda : ให้ฟอนต์ garuda เป็นฟอนต์ปริยายของเอกสาร
    • norasi : ให้ฟอนต์ norasi เป็นฟอนต์ปริยายของเอกสาร
    • laksaman : ให้ฟอนต์ laksaman เป็นฟอนต์ปริยายของเอกสาร
    • loma : ให้ฟอนต์ loma เป็นฟอนต์ปริยายของเอกสาร
    • purisa : ให้ฟอนต์ purisa เป็นฟอนต์ปริยายของเอกสาร
    • sawasdee : ให้ฟอนต์ sawasdee เป็นฟอนต์ปริยายของเอกสาร
    • ttype : ให้ฟอนต์ ttype เป็นฟอนต์ปริยายของเอกสาร
    • ttypist : ให้ฟอนต์ ttypist เป็นฟอนต์ปริยายของเอกสาร
    • umpush : ให้ฟอนต์ umpush เป็นฟอนต์ปริยายของเอกสาร
    • waree : ให้ฟอนต์ waree เป็นฟอนต์ปริยายของเอกสาร
    ตัวเลือกกลุ่มนี้กำหนดฟอนต์ปริยายของทั้งเอกสาร โดยไม่ได้เปลี่ยนฟอนต์ทั้งสามตระกูล (อาจจะเหมาะกับเอกสารที่ใช้ฟอนต์เดียวทั้งเอกสาร เช่นหนังสือราชการไทยที่บังคับใช้ฟอนต์สารบรรณ)

ตัวอย่าง use case:

  • ต้องการใช้ฟอนต์ลักษมัณ (ดัดแปลงจากสารบรรณ) ทั้งเอกสาร (เช่น ในหนังสือราชการ):
    \usepackage[laksaman]{fonts-tlwg}
    
  • ต้องการใช้ฟอนต์ลักษมัณเป็น sans-serif (เช่น ในคำสั่ง \textsf{}) แทนฟอนต์ครุฑ (ฟอนต์ปริยายยังคงเป็น norasi):
    \usepackage[sflaksaman]{fonts-tlwg}
    
  • ต้องการใช้ฟอนต์ลักษมัณเป็นฟอนต์ปริยาย โดยต้องการผสมกับฟอนต์ roman, teletype ปกติ:
    \usepackage[sans,sflaksaman]{fonts-tlwg}
    
  • ต้องการใช้ฟอนต์ลักษมัณผสมกับฟอนต์กินรี โดยลักษมัณเป็นฟอนต์ปริยาย:
    \usepackage[sans,sflaksaman,rmkinnari]{fonts-tlwg}
    
  • ต้องการใช้ฟอนต์กินรีอย่างเดียวทั้งเอกสาร:
    \usepackage[kinnari]{fonts-tlwg}
    
  • ต้องการใช้ฟอนต์ครุฑผสมกับฟอนต์กินรี โดยฟอนต์ครุฑเป็นฟอนต์ปริยาย:
    \usepackage[sans,sfgaruda,rmkinnari]{fonts-tlwg}
    

เป็นฟีเจอร์ใหม่สำหรับ fonts-tlwg รุ่นหน้าที่จะรอออกรุ่นต่อไปครับ

ป้ายกำกับ: ,

18 มีนาคม 2557

Fonts-TLWG 0.6.0

ออกไปแล้วเมื่อวาน สำหรับ Fonts-TLWG 0.6.0 สำหรับรุ่นนี้ การเปลี่ยนแปลงที่สำคัญที่ทำให้ถึงกับต้องเพิ่มเลขรุ่นที่เลขกลาง ก็คือการรองรับภาษาชาติพันธุ์อย่างมีการเตรียมการ

สำหรับข้อมูลเบื้องต้นเกี่ยวกับภาษาชาติพันธุ์ กรุณาอ่าน blog เก่า และ บทความของคุณอนงค์ เพิ่มเติม

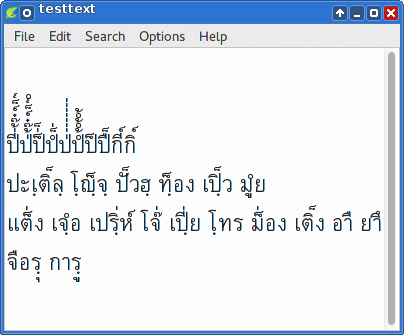
ที่ว่า รองรับอย่างมีการเตรียมการ ก็เพราะในรุ่นก่อนก็สามารถรองรับได้ในระดับหนึ่ง หลังจากที่ Pango 1.31.0 (GNOME 3.6) ขึ้นไปได้โละ engine ภาษาไทยที่ใช้ วทท. 2.0 (มอก. 1566-2541) ทิ้ง และย้ายไปใช้ HarfBuzz จัดการแทน ก็ทำให้กระบวนการวาดภาษาไทยย้ายหนีจาก วทท. 2.0 มาเป็น normalization ตามข้อกำหนดยูนิโค้ด โดยปริยาย ซึ่งข้อกำหนดนี้จะผ่อนคลายกว่า วทท. 2.0 ที่ผูกติดกับภาษาไทยเพียงภาษาเดียว เพราะยูนิโค้ดได้เตรียมการเผื่อการใช้อักษรไทยเขียนภาษาชาติพันธุ์ต่าง ๆ เอาไว้ด้วย ทำให้ฟอนต์ชุด TLWG รุ่นเก่าก็สามารถใช้เขียนภาษาชาติพันธุ์ได้ทันที แต่จะเป็นการวางอักขระซ้อนกันแบบไม่มีการจัดตำแหน่ง บางกรณีก็วางแล้วไม่ซ้อนกัน บางกรณีก็ซ้อนทับกัน แต่ในฟอนต์รุ่น 0.6.0 นี้ มีการออกแบบเพื่อรองรับกรณีต่าง ๆ ให้จัดวางอักขระได้อย่างสวยงาม

ข้อกำหนด วทท. 2.0 นั้น มีลำดับการซ้อนสระและวรรณยุกต์ตายตัวตามอักขรวิธีภาษาไทย แต่เมื่ออักษรไทยถูกใช้เขียนภาษาชาติพันธุ์ จะมีการดัดแปลงอักขระบางตัวเพิ่มเติม เช่น ใช้ไม้ไต่คู้กำกับเหนือสระบน ใช้วรรณยุกต์เหนือไม้ไต่คู้ ใช้ทัณฑฆาตหรือยามักการเป็นวรรณยุกต์เพิ่มเติม การประพินทุใต้สระ การวางสระบนเหนือสระอา หรือกระทั่งดัดแปลงไม้ตรีใช้เป็นสระพิเศษ!

Ethnic languages using Garuda font

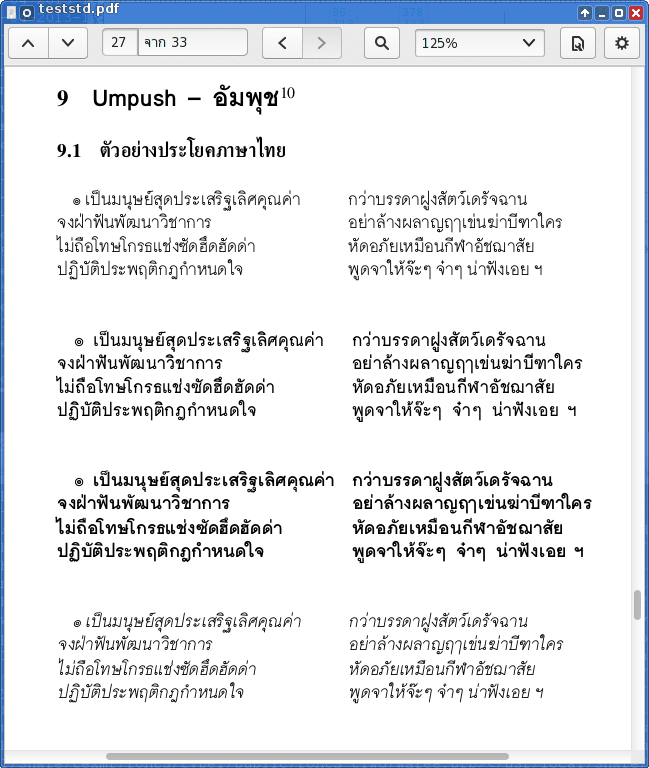
ภาษาชาติพันธุ์ที่ใช้ในรูป (ตั้งแต่บรรทัดที่สองเป็นต้นไป ส่วนบรรทัดแรกใช้ทดสอบฟอนต์ตามข้อกำหนดยูนิโค้ดเท่านั้น) :-

  • ภาษากูย/ส่วย (สุรินทร์) [1]:
    • ปะเฺติ็ลฺ = ขันตักน้ำ
    • โฺญฺ็จฺ = หยุดกึกเพราะกลัวหรือตกใจ
  • ภาษาเขมรถิ่นไทย (สุรินทร์):
    • ปั็วฮฺ
    • ทฺ็อง
    • เปฺิ็ว
    • มูํย
  • ภาษาบรู/ข่า:
    • แต็่ง = to spread
    • เจฺํอ = already
    • เปรฺิ่ห์ = dirty
    • โจ๊่ = bunch of bamboo
    • เปฺี่ย = to mix
  • ภาษาโส้:
    • โฺทร = โส้ (ชื่อภาษา)
  • ภาษาช์อง (จันทบุรี):
    • ม็่อง
  • ภาษาญัฮกุร [อ่านว่า ญะกุ้น] (ชัยภูมิ):
    • เติ็ง
  • ภาษาละว้า:
    • อาื = chase
    • ยาึ = mine
  • ภาษามลายูปาตานี [2]:
    • จือรฺุ
    • การฺู

การใช้งานเหล่านี้ นอกจากทำให้ต้องยกเครื่องจาก วทท. 2.0 เป็นยูนิโค้ดแล้ว ยังมีผลต่อการออกแบบฟอนต์ที่ต้องรองรับกรณีพิเศษเพิ่มเติมด้วย

สำหรับฟอนต์ TrueType/OpenType สิ่งที่ทำเพิ่มก็คือ:

  • เพิ่ม glyph สำหรับอักขระยกสูงเพิ่มเติม นอกจากชุดวรรณยุกต์ปกติในฟอนต์ทั่วไปแล้ว ก็ต้องมีไม้ไต่คู้ นิคหิต และยามักการยกสูงเพิ่มด้วย โดย glyph ชุดนี้จะมีขนาดย่อส่วนลงเล็กน้อย แต่ไม่ใช่ scale down ตามปติ เพราะจะทำให้ได้เส้นที่บางลง แต่จะเป็นการวาดด้วยเส้นหนาเท่าเดิมให้ตัวเล็กลง
  • เพิ่มกฎ GSUB ในการแปลงอักขระชุดดังกล่าวให้เป็นตัวยกสูง โดยต้องครอบคลุมทุก combination ไม่ใช่แค่ที่มีในภาษาไทย
  • เพิ่ม anchor ให้กับอักขระเหนือบรรทัด ให้สามารถซ้อนกันได้ครบทุกคู่ ไม่ใช่แค่ที่มีในภาษาไทย
  • เพิ่ม anchor ชนิด BelowMark อีกชนิดหนึ่งในตาราง 'mkmk' (mark to mark) เพื่อรองรับการซ้อนสระล่างใต้พินทุ พร้อมทั้งเพิ่ม anchor ให้กับ glyph แต่ละ glyph ให้ครบ

นอกจากนี้ ยังได้ ส่งแพตช์ สำหรับแก้ให้ HarfBuzz normalize อักขระใต้บรรทัดให้พินทุมาก่อนสระล่างอย่างถูกต้องด้วย ซึ่งแพตช์ยังอยู่ระหว่างอภิปราย

แต่เนื่องจากฟอนต์ชุด TLWG ยังมีการใช้งานใน LaTeX (pdfTeX engine) ด้วย ซึ่งใน LaTeX ยังคงใช้ PUA glyph แบบเก่า (ที่เรียกกันว่า ตัวหลบ) อยู่ ไม่สามารถใช้ประโยชน์จากการปรับข้อมูล OpenType ข้างต้นได้ จึงต้องปรับขยายกฎ LIGKERN ให้ครอบคลุมกรณีของภาษาชาติพันธุ์เพิ่มเติม กล่าวคือ ต้องเพิ่มกฎต่อไปนี้:

  • ใช้วรรณยุกต์ยกสูงถ้าตามหลังไม้ไต่คู้ วรรณยุกต์ หรือทัณฑฆาต (กฎ LIGKERN ใน LaTeX จะใช้วรรณยุกต์ตัวลดต่ำโดยปริยาย แล้วค่อยใช้กฎ LIGKERN ยกให้สูงขึ้น ซึ่งจะกลับกันกับฟอนต์บนเดสก์ท็อป)
  • ใช้วรรณยุกต์ยกสูงหลบซ้ายถ้าตามหลังไม้ไต่คู้ วรรณยุกต์ หรือทัณฑฆาตที่หลบซ้าย
  • ใช้สระบนที่หลบซ้ายถ้าตามหลังพินทุที่ตามหลังพยัญชนะหางยาว (ป ฝ ฟ ฬ)
  • ใช้สระอุ อู ลดต่ำเมื่อตามหลังพินทุ
  • generalize กฎอื่น ๆ ที่บังเอิญเจาะจงเฉพาะกรณีที่ปรากฏในภาษาไทยไว้ เช่น ใช้นิคหิตหลบซ้ายหลังสระอูและพินทุที่ตามหลังพยัญชนะหางยาว, ใช้สระบนหลบซ้ายถ้าตามหลังสระอุ อู ที่ตามหลังพยัญชนะหางยาว)

นั่นคือสิ่งที่ทำได้ในตอนนี้สำหรับ LaTeX ยังมีกรณีที่ขาดเหลืออยู่ซึ่งยังไม่สามารถทำได้ เนื่องจากตาราง LTH encoding เต็มแล้ว ไม่มีช่องเหลือให้เพิ่ม PUA glyph เช่น

  • ยามักการยกสูง
  • ไม้ไต่คู้ นิคหิต ยามักการ ที่ยกสูงและหลบซ้าย

ถือเป็นข้อจำกัดที่ต้องพยายามหาทางแก้ไขในรุ่นถัดไป แต่ขณะนี้ก็ถือว่าครอบคลุมกรณีในภาษาชาติพันธุ์ได้พอสมควรแล้ว (ข้อจำกัดนี้มีเฉพาะสำหรับ pdfTeX เท่านั้น ส่วนฟอนต์บนเดสก์ท็อป หรือ XeTeX รองรับครบทุกกรณี)

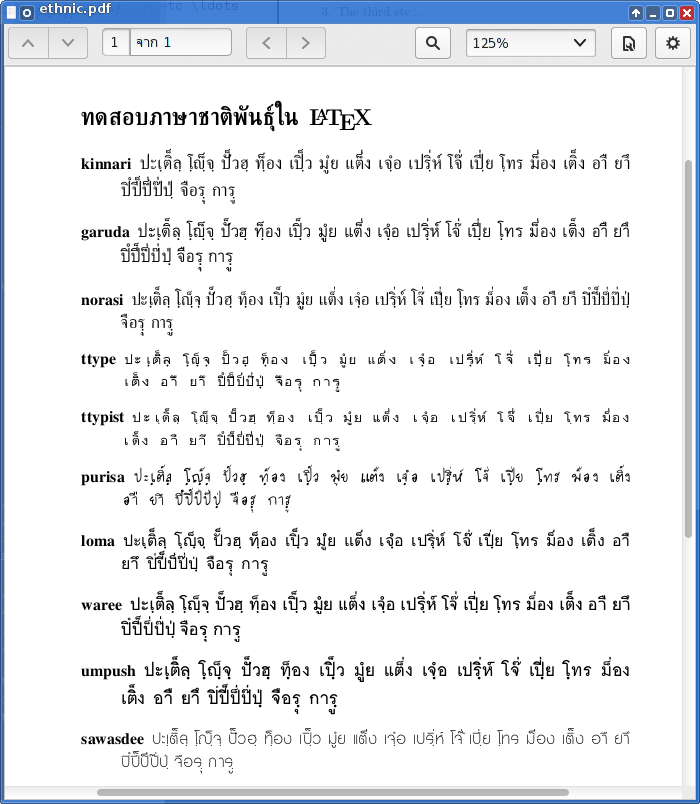
Ethnic languages in LaTeX

ผลพลอยได้ระหว่าง fine-tune ฟอนต์ก็คือ ได้เพิ่มฟอนต์ Umpush Light สำหรับการใช้งานใน LaTeX แล้วด้วย โดยสามารถกำหนดฟอนต์ด้วยคำสั่ง \usefont เช่น

  \usefont{LTH}{umpush}{l}{n}   % ตัวตรง
  \usefont{LTH}{umpush}{l}{it}  % ตัวเอียง

Umpush Light in LaTeX

ฟอนต์รุ่นนี้ ได้อัปโหลดเข้า Debian sid (สำหรับเดสก์ท็อป) และที่ CTAN (สำหรับ LaTeX) แล้วทันทีหลังจากออกรุ่นที่ต้นน้ำ สำหรับ LaTeX ใน Debian นั้น ต้องรอทีม TeX ของ Debian อัปเดตพร้อมกับภาษาอื่น ๆ ในแพกเกจ texlive-lang-other ต่อไป

อ้างอิง:

[1]
นเรศ นโรปกรณ์. (๒๕๓๖). อัจฉริยลักษณ์และความเป็นวิทยาศาสตร์ของลายสือไทย. พิมพ์ครั้งที่ ๑. กรุงเทพฯ : โอเดียนสโตร์. ISBN 974-276-975-3.
[2]
ราชบัณฑิตยสถาน. (๒๕๕๓). คู่มือระบบเขียนภาษามลายูปาตานีอักษรไทย ฉบับราชบัณฑิตยสถาน. พิมพ์ครั้งที่ ๑. กรุงเทพฯ : ราชบัณฑิตยสถาน. ISBN 978-616-7073-25-5.

ป้ายกำกับ: , ,

08 พฤศจิกายน 2556

Thanks, and the September-October Diary

ขอขอบคุณผู้สนับสนุนงานพัฒนาของผมในเดือนกันยายน-ตุลาคมที่ผ่านมาดังนี้ครับ:

เป็นอีกครั้งหนึ่งที่ต้องเขียน blog แบบรวบสองเดือน เนื่องจากภารกิจต่าง ๆ ค่อนข้างเร่งรัด จนอยากใช้เวลาสะสางงานให้เต็มที่มากกว่า

งานในช่วงสองเดือนที่ผ่านมา แบ่งเป็นหมวด ๆ ดังนี้ครับ:

โครงการอักษรอีสาน

งานพัฒนาที่ LTN และ Debian

เป็นการปล่อยสิ่งที่พัฒนาสะสมมาตั้งแต่ระลอกที่แล้วเมื่อต้นปี โดยทยอยตรวจสอบความเรียบร้อยและออกรุ่นซอฟต์แวร์ต่าง ๆ ดังนี้:

  • libdatrie 0.2.7
    • แก้ไขประเด็นเรื่อง portability เกี่ยวกับ void pointer arithmatics ซึ่งจะมีปัญหากับคอมไพเลอร์ที่ไม่ใช่ GCC โดยได้รับรายงานจากคุณ Mikhail Korobov ว่าคุณ Gabi Daver ได้พบปัญหานี้ขณะคอมไพล์ด้วย Visual C++ พร้อมแพตช์แก้
    • ระหว่างแก้ ได้ทดลองคอมไพล์ด้วยตัวเลือก -Wall ทำให้เจอ warning เพิ่มเติม และแก้ไขจนหมด
    • เขียน test case เพื่อให้สามารถตรวจสอบความถูกต้องเวลาแก้โค้ดได้ในอนาคต ที่ผ่านมาจะทดสอบผ่าน libthai เป็นหลัก แต่เขียน test case เป็นเรื่องเป็นราวน่าจะสะดวกกว่า ซึ่งในระหว่างที่เขียน test case ก็ทำให้ได้อ่านเอกสารประกอบและแก้ไขที่ผิด พร้อมกับได้เพิ่ม API เพื่อความสะดวกในการใช้งานด้วย
    • ปรับ Doxyfile ที่ใช้สร้างเอกสาร เพื่อตัดสิ่งที่เลิกใช้แล้วใน doxygen 1.8.4
    • ออก libdatrie 0.2.7.1 ตามมา หลังจากพบว่าลืมปรับค่า library version เพื่อให้ SONAME สะท้อนการเพิ่ม API ที่เกิดขึ้น
    • อัปโหลด 0.2.7.1-1 เข้า Debian sid
  • thaixfonts 1.2.6
    • มีการปรับระบบ build ตาม autoconf รุ่นใหม่ และเปลี่ยนมาใช้ XZ tarball แทน GZ tarball ซึ่งเป็นสิ่งที่ทำไว้นานแล้ว ก็ออกรุ่นมาเพื่อปรับตามซอฟต์แวร์อื่นเท่านั้น ส่วนตัวเนื้อหาฟอนต์ไม่มีการเปลี่ยนแปลงอะไร
    • อัปโหลด 1:1.2.6-1 เข้า Debian sid
  • LibThai 0.1.20
    • ปรับข้อมูลพจนานุกรมตัดคำตามที่พบกรณีต่าง ๆ ในช่วงที่ผ่านมา [เกร็ด: รุ่นนี้รู้จักอำเภอขนอมที่ไม่ใช่ ขน-อม แล้ว ;-)]
    • แก้ compiler warning ที่พบใน test case ต่าง ๆ
    • อัปโหลด 0.1.20-1 เข้า Debian sid
  • TeX hyphenation patterns
    • sync ข้อมูลพจนานุกรมตัดคำจาก libthai เข้าไปที่ ThaiLaTeX SVN พร้อมกับปรับแก้ hyphenation patterns ตามข้อมูลใหม่
    • แจ้งไปที่โครงการ tex-hyphen ว่าขอปรับข้อมูล hyphenation patterns ภาษาไทย พร้อมกับรายงานปัญหาของสคริปต์บางตัวที่ใช้สร้างข้อมูลอัตโนมัติ คุณ Mojca Miklavec ก็ได้ช่วยแก้สคริปต์ให้ (rev 652, 653) และรับแพตช์ปรับข้อมูลภาษาไทยไปรวมให้ (rev 654)
    • สอบถามและขอ import source ของ hyphenation patterns ภาษาไทยเข้าใน tex-hyphen โดยตรง เพื่อที่ต่อไปจะได้ไปทำงานที่นั่นแทนที่จะต้องผ่าน ThaiLaTeX แบบนี้ ทั้งนี้เพื่อให้เป็นไปตามแผน ที่เคยคุยกันไว้ จนกระทั่งได้ import source ใน rev 655
    • ไม่มีการอัปโหลดอะไรใน Debian แค่รอ Debian อัปเดตแพกเกจ texlive-base เท่านั้น
    • request ขอลบ thailatex ออกจาก Debian unstable เพื่อไม่ให้มีซอร์สตกค้างอยู่ (ลบแล้ว)
  • swath 0.5.1
    • แก้รหัสตัดคำของ Lambda จาก U+200C (ZWNJ) เป็น U+200B (ZWSP) ...ว่าแต่มีใครใช้ฟีเจอร์นี้ไหมเนี่ย?
    • sync ข้อมูลพจนานุกรมตัดคำจาก ThaiLaTeX/hyph-utf8 (ซึ่ง sync มาจาก LibThai อีกที) เพื่อให้ตัวตัดคำ LaTeX ทำงานสอดคล้องกับ hyphenation patterns
    • ก่อนออกก็ปรับซอร์สโค้ดของ swath เพื่อให้แต่ละรุ่นมีการปรับปรุงด้านความปลอดภัยไปทีละน้อย โดยในรุ่นนี้ได้ป้องกัน buffer overflow ใน file filter ต่าง ๆ (ยังมีให้แก้อีกเยอะในรุ่นถัด ๆ ไป :-P )
    • อัปโหลด 0.5.1-1 เข้า Debian sid
  • IBus-LibThai 0.1.2
    • แก้ปัญหาการกด shortcut (เช่น Ctrl-C) ใน IBus 1.5 อันเนื่องมาจากการเชื่อมรวมกับ XKB ของ IBus รุ่นนี้ ทำให้ผังแป้นพิมพ์ที่ระบุใน metadata ของ IBus-LibThai ว่าเป็น th ทำให้กด Ctrl-C ได้เป็น Ctrl-แ เสมอ แก้ไขโดยปรับผังแป้นพิมพ์เป็น us เท่านั้น
    • อย่างไรก็ดี การแก้ปัญหาในรายการที่แล้วทำให้เกิดปัญหาใหม่ คือทำให้กด accelerator ใน GUI ที่แปลเป็นไทย (เช่น Alt-ฟ เพื่อเรียกเมนู แฟ้ม) ไม่ได้ วิธีแก้ที่เหมาะสมจึงควรให้ IBus-LibThai พยายามแปลง key event ที่มีการกดปุ่มประกอบให้เป็นภาษาไทย แต่ปรากฏว่าไม่สามารถส่ง event ที่แปลงแล้วกลับไปหา event queue ได้ เนื่องจากฟังก์ชัน ibus_engine_forward_key_event() ไม่ทำงานอย่างที่คาด งมอยู่นานก็ไม่สามารถแก้ได้ เวลามีจำกัดจึงใช้วิธีกำหนดผังแป้นพิมพ์เป็น us,th เพื่อให้ GTK+ กับ XKB ไปคุยกันเอง ซึ่งก็ได้ผล แต่ปัญหาคือ มันจะแปลงอักขระตามผังเกษมณีเท่านั้น ใครใช้ผังปัตตะโชติใน IBus-LibThai ก็จะงง ไว้หาวิธีแก้ต่อไปในรุ่นหน้า
    • เพิ่มการรองรับการป้อนเลขไทยด้วยแป้นตัวเลข โดยอาศัยการกด CapsLock ล็อคไว้ หรือใช้การยกแคร่ระดับ 3 (Alt ขวา) อนึ่ง ตามที่เคยได้ ออกแบบไว้ เมื่อสองปีก่อนนั้น จะใช้ ScrollLock ไม่ใช่ CapsLock เนื่องจาก CapsLock จะไปเพิ่มขั้นตอนขณะสลับภาษาไปเป็นภาษาอังกฤษที่จะต้องปลด CapsLock อีกขั้นหนึ่งด้วย แต่ในครั้งนี้ได้ตัดสินใจเปลี่ยนเป็น CapsLock ด้วยเหตุผลสองประการ ประการแรกคือการตรวจสอบสถานะของ ScrollLock ด้วย API ของ IBus เป็นไปได้ยาก เพราะไม่มีการเตรียมการรองรับไว้ ประการที่สองคือในแป้นพิมพ์ย่อส่วน เช่นแป้นพิมพ์โน้ตบุ๊ก หลายรุ่นได้ตัดปุ่ม ScrollLock ออกไปแล้ว ตามที่ วิกิพีเดียว่าไว้ (โน้ตบุ๊กผมก็ไม่มี)
    • อัปโหลด 0.1.2-1 เข้า Debian sid

งานแปล

  • ตรวจทาน คำแปล GNOME ตามที่มีผู้ส่งคำแปลเข้ามา โดยที่ผมไม่ได้แอคทีฟตามแปลเองอีกต่อไปแล้ว
  • แปล Xfce เป็นไทย เพิ่มเติม โดยล่าสุด ได้แปล core package ต่าง ๆ ครบแล้ว พร้อมกับปรับคำแปลทั้งหมดจาก master กลับไปที่ branch xfce-4.10 ด้วย และแปลปลั๊กอินที่ผมใช้อีกนิดหน่อยเพิ่มเติม ทำให้ขณะนี้อัตราการแปลของภาษาไทยอยู่ที่ 54% แล้ว

blog นี้ก็เลยยาวหน่อย ขอขอบคุณทุกท่านที่ติดตามครับ

ป้ายกำกับ: , , , , , , , , , ,

15 พฤษภาคม 2556

Future of ThaiLaTeX

ช่วงที่ผ่านมามีความเคลื่อนไหวเกิดขึ้นอย่างมากกับโครงการ ThaiLaTeX ว่ากันตามลำดับดังนี้:

feature ต่าง ๆ

  • แก้บั๊กการใช้เลขไทยในจดหมาย
  • จำกัดขอบเขตของ emergencystretch ไม่ให้ไปรบกวนภาษาอื่น
  • ตัดการรองรับ emacs หลังจากที่ได้ อภิปรายในลิสต์ เนื่องจากโค้ดล้าสมัยมาก และไม่มีใครสามารถดูแลปรับปรุงให้ทันสมัยได้ โดยความสะดวกเล็ก ๆ น้อย ๆ ที่ได้ ก็ไม่น่าจะตรงตามความต้องการของผู้ใช้ LaTeX บน emacs โดยทั่วไปมากนัก
  • เพิ่ม option thaiindentfirst เพื่อบังคับให้ร่นย่อหน้าแรกของ section เสมอ โดยเป็นฝีมือของ อ.พฤษภ์ ขอขอบคุณมา ณ ที่นี้

แต่ปรากฏว่ามีความเปลี่ยนแปลงที่ใหญ่กว่านั้นเกิดขึ้น ซึ่งจะส่งผลต่ออนาคตของโครงการ ThaiLaTeX กล่าวคือ:

  • hyphenation pattern ได้เข้ารวมในโครงการ hyph-utf8 แล้ว โดยคุณ Mojca Miklavec จากโครงการดังกล่าวได้พบข่าวประกาศของ thailatex จึงได้ติดต่อมาที่ผมว่าสามารถนำไปรวมเข้าใน hyph-utf8 ได้ ซึ่งจะทำให้ hypenation มีผลกับภาษาไทยมาตั้งแต่ต้นน้ำของ TeX Live เลย โดยไม่ต้องลง thailatex เพิ่ม ซึ่งหลังจากคุยกันพักหนึ่งก็ได้ รวมเข้าไปเรียบร้อย
  • โครงการ babel ได้กลับมามีชีวิตอีกครั้ง หลังจากที่ร้างไปนาน โดยได้ผู้ดูแลคนใหม่คือ Javier Bezos ซึ่งเขาได้แยกส่วนแกนกลางกับส่วนข้อกำหนดของภาษาต่าง ๆ ออกจากกัน ทำให้สามารถเพิ่มภาษาใหม่ ๆ เข้าไปได้อย่างอิสระ ซึ่งหมายความว่า เราสามารถอัปโหลดแพกเกจที่มีไฟล์ที่จำเป็นสำหรับภาษาไทยใน babel เข้า CTAN ได้อย่างอิสระแล้วในตอนนี้

นับตั้งแต่เริ่มโครงการมา ThaiLaTeX ได้ผ่านการเปลี่ยนโครงสร้างครั้งสำคัญมาครั้งหนึ่งในรุ่น 0.4.6 โดยได้ แยกฟอนต์ออกจาก ThaiLaTeX (ตาม แผนงาน) ทำให้ ThaiLaTeX เหลือเพียงข้อกำหนด babel และการรองรับ emacs เท่านั้น

การเปลี่ยนแปลงครั้งสำคัญต่อมา ก็คือรุ่น 0.5.0 โดยมีการเพิ่ม hyphenation patterns (แนวคิด, การดำเนินการ, การเก็บรายละเอียด) เพื่อช่วยลดปัญหาขอบขวาคอลัมน์หยัก อันเนื่องมาจากการขาดแคลนจุดตัดบรรทัดในภาษาไทย

ต่อมา ปรากฏว่า hyphenation ที่เพิ่มเข้ามาหลังสุด ก็ได้เข้ารวมที่ต้นน้ำอย่างรวดเร็ว การรองรับ emacs ก็ถูกตัดออกแล้ว ทำให้ ThaiLaTeX เหลือเพียง babel definition เพียงอย่างเดียวเท่านั้น

ในเมื่อประตูเปิดแล้วสำหรับการส่ง babel definition เข้าต้นน้ำ ก็เท่ากับว่า ThaiLaTeX ไม่จำเป็นต้องมีอยู่อีกแล้ว! ThaiLaTeX must die! และเมื่อตายเรียบร้อย ผู้ใช้ LaTeX ก็ไม่จำเป็นต้องติดตั้งอะไรเพิ่มเพื่อจะใช้ภาษาไทยอีกต่อไปแล้ว ไม่ว่าจะใช้ OS ไหน!

แต่ช้าก่อน ไม่ใช่ว่า ThaiLaTeX จะตายอย่างสมบูรณ์ เรื่องของเรื่องก็คือ babel definition ของภาษาไทยนั้น เราจะเป็นผู้ดูแลโดยอิสระ ซึ่งก็หมายความว่า เรายังต้องแก้ไข ออกรุ่น อัปโหลดเข้าที่ต้นน้ำเองอยู่ การสลายร่างของ ThaiLaTeX จึงเป็นเพียงการเกิดใหม่ในชื่อ babel-thai เท่านั้น แม้ในแง่ของผู้ใช้จะไม่จำเป็นต้องรู้จัก ThaiLaTeX อีกต่อไป แต่สำหรับผู้พัฒนา ก็ยังคงพัฒนาต่อไป ซึ่งรวมถึงการดูแล hyphenation patterns ที่ hyph-utf8 ด้วย

งานของผมที่จะหายไป ก็คือการดูแล debian package ของ ThaiLaTeX (เหลือแต่งานที่ต้นน้ำแทน) งานของผู้ใช้ที่จะหายไป ก็คือการพยายามติดตั้ง ThaiLaTeX เพื่อใช้ภาษาไทยครับ

ทั้งหมดนี้กำลังอยู่ระหว่างดำเนินงาน ถ้ามีความคืบหน้าจะรายงานอีกทีครับ

อ้อ.. แต่ยังเหลืออีกชิ้นหนึ่งที่ยังหาที่ลงที่ต้นน้ำไม่ได้ คือ swath ครับผม อันนี้ไว้ต้องหารือกับเขาต่อไป

ป้ายกำกับ:

15 กุมภาพันธ์ 2556

Fonts-TLWG 0.5.1

fonts-tlwg 0.5.1 ออกแล้ว น่าจะเป็น release สุดท้ายของช่วงนี้ ซึ่งเป็นการปล่อยของที่สะสมไว้ในช่วงปีที่ผ่านมา (fonts-tlwg 0.5.0 ออกไปเมื่อ 15 ก.พ. 2555 รุ่นนี้ก็ครบหนึ่งปีพอดี)

ความจริงรุ่นนี้มีการเปลี่ยนแปลงไม่มากนัก แต่สิ่งที่สะสมไว้นานวันก็สมควรปล่อยออก การเปลี่ยนแปลงที่สำคัญคือ:

  • เพิ่ม glyph บางตัวที่พบว่าขาดหายไปในฟอนต์ monospace (TlwgTypist, TlwgTypo, TlwgTypewriter, TlwgMono) แต่มีการอ้างถึงในแฟ้ม enc ของ LaTeX รายการนี้เป็นผลจากการ revise แฟ้ม enc ใน ThaiLaTeX 0.4.7 นู้น แล้วมาพบไล่หลังว่ามี glyph ขาดหายในชุด mono ก็เพิ่มให้ครบ
  • แก้ปัญหาเงื่อนไขการ match ฟอนต์ใน fontconfig ที่ผิดรูปแบบ ซึ่ง fontconfig รุ่นใหม่ (ในขณะนั้น) จะเริ่มบ่น Akira Tagoh ได้รายงานไว้ใน RedHat #837538 และ Daiki Ueno ได้แจ้งผมผ่านทางเมลพร้อมเสนอวิธีแก้ แพตช์นี้ผมได้ backport เข้า Debian ไปก่อนตั้งแต่ตอนนั้นแล้วด้วย ตอนนี้ก็ปล่อยออกที่ต้นน้ำเลย
  • เพิ่ม glyph สำหรับภาษาเอสเปอรันโตในฟอนต์ Purisa ซึ่ง Pablo Busto ได้ส่งแพตช์ให้ผมทางเมล ถือได้ว่าฟอนต์นี้ยังคงเป็นที่นิยมของชาวต่างประเทศอยู่เช่นเคย

เช่นกัน fonts-tlwg รุ่นนี้เป็นรุ่นแรกที่ออก tarball โดย บีบอัดแบบ XZ ซึ่งขนาดของ tarball ลดลงอย่างฮวบฮาบถึง 48% สำหรับ source และ 43% สำหรับ binary (TTF)

-rw-r--r--  1 thep thep 5612877 ก.พ.  15 14:14 fonts-tlwg-0.5.1.tar.gz
-rw-r--r--  1 thep thep 2923204 ก.พ.  15 14:10 fonts-tlwg-0.5.1.tar.xz
-rw-r--r--  1 thep thep 3102815 ก.พ.  15 14:27 ttf-tlwg-0.5.1.tar.gz
-rw-r--r--  1 thep thep 1765300 ก.พ.  15 14:26 ttf-tlwg-0.5.1.tar.xz

พร้อมกันนี้ ก็ได้อัปโหลดฟอนต์สำหรับ LaTeX เข้า CTAN แล้ว (รอรีวิว) และได้อัปโหลดแพกเกจเข้า Debian experimental แล้วด้วย

ป้ายกำกับ: ,

08 กุมภาพันธ์ 2556

ThaiLaTeX 0.5.1

ต่อจาก LibThai 0.1.19 ก็มาเป็น ThaiLaTeX 0.5.1 ที่ออกตามมา โดยมีการ sync ข้อมูลพจนานุกรมจาก LibThai มาเพื่อสร้าง hyphenation pattern ใหม่ พร้อมกับปรับกฎการแทรกยัติภังค์ให้เป็นไปตามที่กำหนดในพจนานุกรมทุกคำ

อีกรายการหนึ่ง เป็นเรื่องของความพยายามแก้ปัญหาขอบขวาหยักในการจัดหน้าเอกสาร ซึ่งผมเคยเจอเองบ้าง ได้ฟังผู้ใช้ถามวิธีแก้เข้ามาหลายครั้งหลายหน

ปัญหาขอบขวาไม่เรียบนี้ เป็นผลมาจากอัลกอริทึมการจัดบรรทัดของ TeX ที่พยายามไม่ให้มีช่องว่างในบรรทัดมากเกินไปจนบางตาเป็นจุด ๆ หรืออ่านแล้วสายตาต้องกระโดดข้ามช่องว่างไกลเกินไป ดังนั้น การยืดช่องว่างระหว่างคำของ TeX จึงทำอย่างจำกัด

เรื่องนี้อาจจะดีสำหรับข้อความภาษาอังกฤษ เพราะมีช่องว่างให้ยืดหลายจุด ยืดจุดละนิดละหน่อยก็ได้ความกว้างเพิ่มมาพอแล้ว แต่พอมาจัดบรรทัดภาษาไทยจะเจอปัญหาขาดแคลนช่องว่าง เพราะภาษาไทยไม่มีช่องว่างระหว่างคำ ผลคือ เมื่อยืดช่องว่างเท่าที่ยอมยืดแล้ว บรรทัดก็ยังกว้างไม่ถึงขอบขวา ดังนั้น TeX จึงเลือกที่จะดึงคำของบรรทัดถัดไปมาเติมช่องว่างแทน ซึ่งแน่นอนว่าทำให้บรรทัดกว้างเกินขอบขวา เกิด overfull line ถึงแม้จะไม่สวย แต่มันก็เป็นทางเลือกที่ดีที่สุดเท่าที่มีตามข้อกำหนดของ TeX อาการนี้อาจเป็นข้อยกเว้นที่แทบไม่เจอเลยในภาษาอังกฤษ แต่กลับเป็นกรณีที่พบบ่อยมากสำหรับภาษาไทย

วิธีแก้ปัญหานี้เป็นไปได้หลายแบบ เช่น

  • ใช้ letter spacing เป็นวิธีที่นิยมมากในงานพิมพ์ของไทย แม้ของฝรั่งเองก็เคยเห็นบ้าง แต่โดยหลักการแล้วถือว่าเป็นสไตล์ที่ไม่ดี (Frederick Goudy เคย กล่าว ไว้ว่า “Men who would letterspace lower case would shag sheep.”) โดยเฉพาะกับตัวพิมพ์เล็ก และ TeX ก็ไม่ทำ เพราะมันจะทำให้ข้อความอ่านยาก และจะใช้ ligature ไม่ได้ ดังนั้น หากจะทำ letter spacing กับภาษาไทยใน TeX คงไม่ใช่ความคิดที่ดีนัก
  • แทรกช่องว่างระหว่างคำ เป็นวิธีที่ ThaiLaTeX เคยใช้ในระหว่างรุ่น 0.2.5 ถึง 0.4.7 โดยดัดแปลงคำสั่ง \wbr ให้สามารถยืดความกว้างได้ แต่ปัญหาคือ ทำให้คำแยกออกจากกันเป็นคำ ๆ ดูไม่สวยงาม ในที่สุดก็เลิกใช้ไป
  • ยอมให้ยืดช่องว่าง เป็นวิธีที่ TeX เปิดให้จูนได้ โดยกำหนดค่า \pretolerance, \tolerance หรือ \emergencystretch ซึ่งการกำหนดค่า tolerance สูง ๆ อาจทำให้คุณภาพโดยรวมของการจัดบรรทัดตกได้ ผมจึงทดลองใช้ \emergencystretch กับเอกสารของตัวเองอยู่พักหนึ่ง จนได้ค่าที่เหมาะสมคือ 0.6em จนเมื่อ อ.กิตติพงษ์ มาถามผมในการประชุม “โสเหล่” ของ Khon Kaen Linux User Group (KKLUG) ครั้งหนึ่ง เป็นสัญญาณให้ผมตัดสินใจว่ามันเป็นสิ่งที่จำเป็นสำหรับการใช้ภาษาไทยใน LaTeX แล้ว ไม่ใช่สิ่งที่จะเก็บไว้เป็น solution ส่วนตัวอีกต่อไป จึงได้ commit เข้าใน SVN ของ ThaiLaTeX เสีย

ก็อยากให้ทดลองใช้กันดูนะครับ อาจมีวิธีที่ดีกว่านี้ หรือได้ค่า stretch ที่เหมาะกว่านี้ ก็เสนอเข้ามาได้ครับ

รุ่นนี้เป็นรุ่นแรกของ ThaiLaTeX ที่เปลี่ยนมาใช้ tarball แบบ XZ ตามประกาศ LTN ซึ่งปรากฏว่าขนาด tarball ลดลงถึง 26%

-rw-r--r-- 1 thep thep 260914 ก.พ.   8 12:02 thailatex-0.5.1.tar.gz
-rw-r--r-- 1 thep thep 191580 ก.พ.   8 11:35 thailatex-0.5.1.tar.xz

พร้อมกันนี้ ก็ได้อัปโหลดเข้า CTAN ไปแล้ว (รอ moderator รีวิวให้ถึงจะได้เข้า) รวมทั้งอัปโหลดเข้าที่ Debian experimental ไปรอ Jessie ไว้ด้วย

ป้ายกำกับ:

18 มิถุนายน 2555

ThaiLaTeX 0.5.0 et al

fine-tune แล้ว แถม super-tune อีก โดยผมได้ทดลองใช้กับเอกสารจริงควบคู่กันมาตลอดด้วย ก็ได้เวลาเข็นทุกสิ่งที่ได้พัฒนาสะสมมาสู่ผู้ใช้เสียที

เริ่มจาก LibThai 0.1.18 ก่อน โดยในระหว่างปรับแก้พจนานุกรม hyphenation ของ ThaiLaTeX ก็ทำให้พบคำสะกดผิดในพจนานุกรม จึงกลับไปแก้พจนานุกรมตัดคำของ LibThai ด้วย เมื่อรวมกับการเพิ่มคำใหม่ ๆ ในพจนานุกรมตามปกติ (สำหรับรอบนี้ก็เช่นคำว่า ชยันตี จากงานฉลองพุทธชยันตีที่ผ่านมา) ก็ทำให้ได้เป็น LibThai รุ่นล่าสุดนี้ โดยรายการคำที่เพิ่มทั้งหมด ก็ได้ sync เข้าไปที่ ThaiLaTeX ตาม work flow ที่เตรียมไว้แล้วด้วย

จากนั้น ก็ตามมาด้วย swath 0.4.3 ซึ่งได้ถอดเปลี่ยนพจนานุกรมตัดคำมาใช้ชุดเดียวกับที่ ThaiLaTeX ใช้ เพื่อให้จุดแบ่งคำพอดีกันกับ hyphenation pattern ที่จะมาทำงานต่อ ทั้งนี้ได้ให้ swath ดึงพจนานุกรมมาจาก ThaiLaTeX แทนที่จะดึงจาก LibThai โดยตรง เนื่องจาก ThaiLaTeX อาจมีรายการบางรายการที่ปรับเปลี่ยนเพิ่มเติมตามความเหมาะสมของการทำ hyphenation บ้าง (ซึ่งความจริงแทบไม่มีเลย)

สำหรับ swath นี้ ความจริงยังมีงานพัฒนาบางส่วนที่ผมยังทำค้างไว้ใน local branch ในเครื่องผม เกี่ยวกับการแปลงรหัสอักขระ แต่ยังไม่ได้ merge เข้ามาในรุ่นนี้ ไว้ทำเสร็จจริง ๆ แล้วค่อย merge สำหรับรุ่นหน้าต่อไป

สุดท้าย ก็เป็นพระเอกของชุดนี้ คือ ThaiLaTeX 0.5.0 ซึ่งได้ขึ้น minor version เลขใหม่ อันเนื่องมาจากฟีเจอร์ใหม่ที่เพิ่มขึ้นอย่างมีนัยสำคัญ โดยก็ได้อัปโหลดไว้ที่ CTAN (พร้อม TDS installation image) ด้วย

สำหรับ ThaiLaTeX นี้ ถ้าใครติดตั้งจากซอร์สจะมีขั้นตอนที่ต้องแก้เองด้วยมือหลังจาก make install ด้วย เนื่องจากแต่ละระบบมีระบบจัดการ config เรื่อง hyphenation ไม่เหมือนกัน ซึ่งผมได้ทดลองเพียง Debian unstable และ Fedora 17 เท่านั้น รายละเอียดได้เขียนบันทึกไว้ใน README.hyphen ในซอร์สแล้ว

และแน่นอน ทั้งสามรายการนี้ ได้อัปโหลดเข้า Debian unstable แล้ว บางคนอาจจะเห็นและได้ใช้ไปบ้างแล้ว ส่วน Ubuntu ก็รอพบได้ในรุ่น 12.10 ต่อไป

ความจริงที่พยายามเร่งออกในช่วงนี้ก็เพื่อให้ทันกำหนด Wheeze freeze ที่ใกล้จะถึงนี้ด้วย

แถมท้ายนิดหนึ่ง ว่าก่อนหน้านั้นได้มีการออก scim-thai 0.1.3 ที่ได้ปรับเอา API ที่เลิกใช้แล้วใน GTK+ 3 ออกไป เนื่องจาก GTK+ 3 รุ่นใหม่นี้จะไม่ยอมให้คอมไพล์ผ่านอีกแล้ว ตามที่ได้รับรายงานใน Debian #676060

ป้ายกำกับ: , , , ,

12 มิถุนายน 2555

ThaiLaTeX Hyphenation Super-tuning

จาก blog ที่แล้ว ที่ผมพูดถึงการ fine-tune hyphenation pattern สำหรับภาษาไทยใน TeX โดยลงท้ายไว้ว่า อีกไม่นานคง release มาให้ทดลองใช้กันนั้น ปรากฏว่ามันไม่ได้ตรงไปตรงมาอย่างที่คิด

ผมได้อัปโหลด snapshot svn20120423 ของ thailatex ไปไว้ที่ Debian experimental และทดลองใช้เตรียมเอกสารที่ใช้งานจริงแทนรุ่นใน sid ก็กลับพบการแทรกยัติภังค์ผิดหลายจุด ทั้ง ๆ ที่ patgen ก็ได้รายงานผลการทดลอง hyphenate ตัวพจนานุกรมต้นทางด้วย pattern ที่ได้ ว่าถูกต้อง 100% โดย error เป็น 0 แล้วก็ตาม การที่ยังพบ error ในเอกสารจริงจึงนับเป็นเรื่องที่ไม่คาดคิด ถ้าเป็นเช่นนี้ ผมก็ยังไม่สามารถ release ได้

แรกสุดนั้น ผมยังมืดแปดด้านว่าจะ debug pattern ยังไง เพราะยังมองระบบเป็น black box อยู่ สุดท้ายจึงได้แนวทาง ว่าต้อง dry run pattern ต่าง ๆ ด้วยอัลกอริทึมที่ TeX ใช้ จึงนับเป็นจุดเริ่มต้นของการล้วงเข้าไปในรหัสของตัว pattern แล้วก็ได้เข้าใจสภาพปัญหามากขึ้น

ไม่ว่าปัญหาของ patgen จะเป็นอะไร แต่การไล่ pattern ก็ทำให้รู้จุดโหว่ของ pattern ที่มันสร้างมา จึงคิดวิธีแก้ด้วยการเพิ่ม ข้อยกเว้น (exception) เข้าไปเอง โดยเพิ่ม level 6 และ 7 เข้ามาจากเดิมที่ให้ patgen สร้างมาแค่ 5 level พอได้วิธีแก้แล้วก็เริ่มแก้ error ที่พบในเอกสารของผม

จากนั้น ก็ทดลองเอาเอกสารเก่า ๆ มาคอมไพล์ใหม่เพิ่มเติม ก็พบ error ใหม่ ๆ อยู่เนือง ๆ ในช่วงแรกก็ได้แต่ไล่แก้ แล้วก็หาเอกสารมาคอมไพล์เพิ่มเติมไปเรื่อย ๆ

ทำไปได้สักพักก็รู้สึกว่าอัตราของ error มันไม่ได้ลดลงเลย พอเจอเอกสารใหม่ ก็ไปเจอ error ที่คำใหม่ แถมเป็น error ที่ไม่น่าให้อภัยด้วย สุดท้ายก็ได้แนวคิดที่จะทดสอบแบบทั่วถึง (thorough test) ไปเลย โดยเขียนสคริปต์ test-hyphen.sh (มีอยู่ใน SVN) เพื่อนำคำที่มีในพจนานุกรมทั้งหมดมาผ่านคำสั่ง \showhyphens{...} ของ TeX เพื่อแสดงจุดแทรกยัติภังค์ทั้งหมดของแต่ละคำ แล้วเปรียบเทียบกับพจนานุกรมต้นทางเพื่อหา error ทั้งหมดที่ยังเหลืออยู่

พอเจอตัวเลขของ error ทั้งหมดถึงกับผงะ คืออยู่ที่ 9,660 รายการ จากรายการคำทั้งหมด 23,785 รายการ คิดเป็น 40% ถือว่าเยอะมากทีเดียว แต่ภายหลังพบว่ามีข้อผิดพลาดของสคริปต์ในการเปรียบเทียบ ทำให้ตัวเลขสูงเกินจริง พอแก้แล้วก็เหลือ error อยู่ 2,574 รายการ คิดเป็นราว 10.8% ก็ยังถือว่าเยอะอยู่ดีสำหรับการไล่แก้แบบ manual

ก็ไม่มีทางเลือก ถ้าต้องการให้มัน release ได้โดยไม่ขายหน้าประชาชี ผมก็ต้องไล่แก้ error เหล่านี้ โดยได้รายงานความคืบหน้าเป็นระยะ ๆ ทาง Google+ และทาง Facebook โดยใช้เวลาร่วม 10 วัน (ไม่นับวันที่พักเพราะป่วย) ในการแก้ error จนเหลือ 0

ระหว่างที่แก้ ก็ได้พบว่าสาเหตุของ error มีได้หลายทาง เช่น

  • พจนานุกรมต้นทางผิดพลาด หรือแทรกยัติภังค์ไม่สอดคล้องกัน บางคำเมื่อเป็นคำโดดแทรกยัติภังค์อย่างหนึ่ง แต่พออยู่ในคำประสมกลับแทรกอีกอย่างหนึ่ง ทำให้ patgen ชั่งน้ำหนักไม่ถูกว่าจะเอาอย่างไหน เป็นต้น
  • กรณีตัวอย่างน้อยเกินไปสำหรับจุดแทรกบางจุด เพราะมีที่ใช้น้อย ทำให้คะแนนที่ได้ไม่ถึง threshold ที่กำหนด กฎจึงไม่ถูกสร้าง
  • จุดแทรกบางจุดมีความแปรปรวนสูง เช่น "-นี' มีทั้งจุดที่แทรก เช่น เส-นีย์, แก-นี-มีด, สถา-นี, ทัศ-นีย์ มีทั้งจุดที่ไม่แทรก เช่น สุ-หนี่, ถนัด-ถนี่, เหนียว, อนี-จะ, เสนียด, เฉนียน ทำให้ patgen ชั่งน้ำหนักไม่ถูก
  • พารามิเตอร์ที่กำหนดให้กับ patgen ในบาง level กำหนดช่วงความยาวที่ทำให้พลาดบาง pattern เช่น ใน level 5 ตั้งความยาวไว้ 4-11 ก็จะพลาด pattern ความยาว 3 ลงมา เป็นต้น ซึ่งตรงนี้ถือว่าจำเป็นต้องทำ เพราะได้ลองกำหนดความยาวต่ำลงแล้ว ปรากฏว่ากฎมัน aggressive ขึ้นมาก ทำให้เกิด error เพิ่มเติมเป็นผลข้างเคียงมากมาย

ก็ถือเป็น error ที่พอเข้าใจได้ แต่ที่ไม่เข้าใจคือ ทำไม patgen จึงไม่รายงาน error เหล่านี้ขณะทดลอง hyphenate พจนานุกรมต้นทาง ซึ่งผลของการไม่รายงาน error ก็ทำให้ patgen ไม่ยอมสร้าง pattern เพิ่มอีกแม้จะบังคับพารามิเตอร์หรือทดลองเพิ่มจำนวน level อีกก็ตาม เพราะมันเองก็เข้าใจว่า error เป็นศูนย์แล้ว ไม่จำเป็นต้องทำเพิ่มอีก

สำหรับ error ที่เกิดจากพจนานุกรม ก็ปรับที่พจนานุกรม ซึ่งในหลายกรณีทำให้ได้กฎเพิ่ม และไปลด error ในกรณีอื่น ๆ ที่เกี่ยวข้องทันทีด้วย ส่วนกรณีอื่น ๆ ก็จำเป็นต้องแก้โดยเพิ่มข้อยกเว้นเป็นรายกรณีไป

บทเรียนจากการทำงานครั้งนี้คือ การทดสอบที่ดีช่วยได้มากในการควบคุมคุณภาพ โดยตอนที่ได้สคริปต์ test-hyphen.sh นั้น ถือเป็นก้าวกระโดดทีเดียว แทนที่จะต้องไปหาเอกสารมาคอมไพล์เรื่อย ๆ ก็แค่สั่งสคริปต์ทดสอบก็รู้ทันทีว่าตอนนี้อัตรา error เป็นเท่าใด และสคริปต์ทดสอบนี้ก็สามารถนำมาใช้กลั่นกรองการเพิ่มคำในพจนานุกรมในอนาคตได้ด้วย ทำให้รู้ว่าจะต้องเพิ่มข้อยกเว้นกำกับอีกหรือไม่ ซึ่งผมก็นำมาใช้จริง โดยเขียนเป็นสคริปต์ diff-dicts.sh อีกตัวหนึ่ง (มีใน SVN อีกเช่นกัน) เพื่อใช้เปรียบเทียบพจนานุกรมเดิมกับพจนานุกรมของ libthai โดยทดลองแทรกยัติภังค์กับคำใหม่แล้วสร้างเป็น diff กับของเดิมเพื่อให้ตรวจสอบก่อนเพิ่มเข้าพจนานุกรมต่อไป ทำให้ work flow สำหรับการ sync พจนานุกรมข้ามโครงการราบรื่นขึ้น

ขั้นต่อไป เพื่อให้การทำงานได้ผลดีที่สุด swath ควรจะเปลี่ยนมาใช้พจนานุกรมชุดเดียวกับที่ใช้สร้าง hyphenation pattern ด้วย เพื่อให้จุดแบ่งคำพอดีกัน และสามารถใช้กฎที่ผ่านการทดสอบกับพจนานุกรมชุดนี้แล้วในการแทรกยัติภังค์อย่างถูกต้อง (สำหรับรุ่นปัจจุบัน ผู้ใช้สามารถใช้ตัวเลือก -d เพื่อใช้พจนานุกรมของ libthai แทนของ swath ไปพลางก่อนได้)

หลังจากปรับพจนานุกรมของ swath แล้ว จึงจะ release thailatex ตัวใหม่ต่อไป

อ้อ.. เกือบลืม.. ระหว่างนี้ ผู้ใช้ Debian สามารถทดลองใช้ thailatex ตัวล่าสุด (svn20120609) ที่แก้เสร็จแล้วได้จาก experimental นะครับ

ป้ายกำกับ: ,

28 มีนาคม 2555

ThaiLaTeX Hyphenation Fine-tuning

ที่ผมเล่าใน blog ที่แล้ว ถึงการทำ hyphenation pattern สำหรับ TeX โดยใช้ patgen และใช้ค่าพารามิเตอร์จาก วิทยานิพนธ์ของ David Antoš นั้น เป็นการทดลองแบบ black box โดยที่ยังไม่เข้าใจโครงสร้างภายในของ patgen แต่เป็น proof-of-concept อีกขั้นหนึ่งเท่านั้น

หลังจากนั้น ผมก็ได้ศึกษาหลักการของ patgen โดยอ่าน วิทยานิพนธ์ของ Franklin Mark Liang จนพอเข้าใจหลักการ จึงสามารถนำมาปรับวิธีสร้าง pattern ของเราได้

Liang ได้เล่าถึงอัลกอริทึมต่าง ๆ สำหรับทำ hyphenation ที่มีอยู่ ซึ่งส่วนใหญ่จะเป็นการใช้กฎของภาษาอังกฤษ แต่งานของเขามุ่งจะสร้าง matching pattern โดยอัตโนมัติจากตัวอย่างข้อมูลที่มีอยู่ ซึ่งจะเป็นวิธีที่ไม่ขึ้นกับภาษา สามารถนำไปใช้กับภาษาใด ๆ ก็ได้

pattern ที่สร้างจะอยู่ในรูป n-gram ของอักขระ พร้อมระบุจุดที่สามารถแทรกยัติภังค์ได้ โดย n-gram ที่ว่านี้จะมีความยาวเท่าไรก็ได้ ขึ้นอยู่กับความเฉพาะเจาะจงของตัว pattern

ตัว pattern จะนำไปสร้างเป็น trie ทำให้ match กับข้อความได้อย่างรวดเร็ว และได้จุดที่สามารถแทรก hyphen ได้ออกมา

Liang พยายามจะให้ pattern ที่ได้สามารถรับประกันได้ว่าจะแทรกยัติภังค์ได้ถูกต้องทั้งหมดสำหรับคำที่อยู่ในพจนานุกรม (ยกเว้นกรณีกำกวมอย่าง re-cord กับ rec-ord ซึ่งภาษาไทยน่าจะไม่มี) ส่วนคำที่ไม่อยู่ในพจนานุกรมก็ปล่อยให้เป็นเรื่องของการอนุมานเอาจากกฎ

วิธีหนึ่งที่เป็นไปได้คือเก็บทุกคำในพจนานุกรมลงใน trie เลย แต่นั่นจะทำให้ฐานข้อมูลใหญ่โดยใช่เหตุ แต่วิธีที่ Liang เสนอคือ ให้แยกกฎเป็นสองกลุ่ม คือกฎสำหรับระบุจุดแทรก กับกฎที่เป็นข้อยกเว้นซึ่งห้ามแทรก ด้วยวิธีนี้ทำให้กฎชุดแรกสามารถอยู่ในรูปอย่างง่ายโดยไม่จำเป็นต้องถูกต้องสมบูรณ์ก็ได้ แล้วกฎชุดถัดมาจะตัดส่วนที่ผิดพลาดออกไป

ทีนี้ ก็สามารถมองต่อไปได้อีก ว่ากฎชุดที่สองนี้ ก็สามารถแบ่งเป็นกฎที่ห้ามแทรก กับกฎที่เป็นข้อยกเว้นให้แทรกได้ ทำให้กฎชุดที่สองสามารถอยู่ในรูปอย่างง่ายได้อีกเช่นกัน โดยข้อยกเว้นจะช่วยเพิ่มความถูกต้องให้อีกที

แล้วก็มองอย่างนี้สลับกันไปเรื่อย ๆ ก็จะได้ว่า กฎชุดที่ 1 แทรกยัติภังค์ก่อน, กฎชุดที่ 2 ลบยัติภังค์ออกจากชุดที่ 1, กฎชุดที่ 3 แทรกยัติภังค์เพิ่มจากชุดที่ 2, กฎชุดที่ 4 ลบยัติภังค์ออกจากชุดที่ 3 ฯลฯ กล่าวคือ กฎในลำดับขั้นคี่จะเป็นกฎแทรกยัติภังค์ กฎลำดับขั้นคู่จะเป็นกฎห้ามแทรกยัติภังค์ โดยกฎจะเพิ่มความละเอียดขึ้นเรื่อย ๆ จนถึงขั้นสุดท้ายที่จะได้ผลลัพธ์ที่ถูกต้อง 100% สำหรับคำที่อยู่ในพจนานุกรม ซึ่งปรากฏว่าการจัดชุดกฎแบบนี้ช่วยลดจำนวน pattern ที่ต้องใช้ลงได้มาก โดยยังคงความถูกต้องสมบูรณ์อยู่เหมือนเดิม

ในการสร้างกฎแต่ละขั้น patgen จะสแกนพจนานุกรมที่เป็นตัวอย่างการแทรกยัติภังค์ เก็บ pattern ที่มีความยาวในช่วงที่กำหนด แล้วประเมิน pattern ว่าสามารถทำได้ถูกต้องกี่กรณี (คือค่า good) ผิดกี่กรณี (คือค่า bad) แล้วเอามาคูณกับ weight ที่กำหนดให้ (คือ good_weight และ bad_weight) หักลบส่วนที่ถูกด้วยส่วนที่ผิดแล้วเลือกเอาเฉพาะ pattern ที่เกิน threshold ที่กำหนด

กล่าวคือในการสร้าง pattern แต่ละขั้น patgen จะถามค่าต่อไปนี้:

  • pat_start, pat_finish คือช่วงความยาว pattern ที่จะสร้าง
  • good weight, bad weight, threshold คือน้ำหนักของความถูกต้องของกฎที่จะกรองมาใช้ good weight คือน้ำหนักด้านการพบจุดแทรกที่ถูกต้อง (ถ้ามาก คือต้องการให้ครอบคลุมจุดที่แทรกได้ให้มากที่สุดไว้ก่อน ผิดไม่เป็นไร), bad weight คือน้ำหนักด้านการพบจุดแทรกที่ไม่ใช่ (ถ้ามาก คือต้องการเฉพาะกฎที่ถูกต้องไว้ก่อน ไม่เน้นการครอบคลุมจุดที่แทรกได้), threshold คือขีดต่ำสุดของคะแนนประเมินที่จะเลือกเอา pattern ไว้

เพื่อช่วยในการออกแบบ pattern ชั้นต่าง ๆ patgen ก็จะประเมินในขั้นสุดท้ายให้ด้วย ว่ากฎเท่าที่สร้างมา เมื่อนำกลับไปใช้กับพจนานุกรม สามารถครอบคลุมจุดแทรก (good) ไปแล้วกี่เปอร์เซนต์, มีจุดแทรกผิด (Liang เรียกว่า bad แต่เพื่อไม่ให้สับสนกับ bad weight ในที่นี้ขอเรียกว่า error) กี่เปอร์เซ็นต์ และยังมีจุดแทรกที่ยังไม่ได้แทรก (missed) กี่เปอร์เซ็นต์ (missed = 100% - good)

จากการทดลองหลาย ๆ แบบ Liang เสนอว่าควรแบ่งกฎเป็น 5 ชั้น โดยมีหลักการดังนี้:

  • ชั้นสุดท้าย ให้เป็นชั้นแทรก (เลขคี่) เก็บรายละเอียดที่เหลือทั้งหมด โดยก่อนมาถึงขั้นนี้ error ควรจะเหลือศูนย์ มีแต่จะเน้นแทรกจุดที่ยังไม่ครอบคลุมเท่านั้น กฎในขั้นนี้ควรมี bad weight เป็นอนันต์ (ในทางปฏิบัติคือให้เป็นค่าสูงมาก ๆ) เพื่อให้แทรกเฉพาะจุดที่ถูกต้องโดยไม่เกิด error อีก
  • ชั้นรองสุดท้าย ให้เป็นชั้นกำจัดจุดแทรกผิด (เลขคู่) โดยเน้นกำจัดแหลก เพื่อให้ error เหลือศูนย์ตามที่ว่าไป ดังนั้นในขั้นนี้ควรมี threshold เป็น 1 (คือเป็นค่าน้อยที่สุด) เพื่อให้ทุกกฎได้ทำงาน และตัวกฎไม่จำเป็นต้องเน้นความถูกต้องมากนัก กล่าวคือ สามารถยอมให้กำจัดจุดที่ถูกอยู่แล้วได้ เพราะถึงอย่างไรชั้นสุดท้ายก็จะครอบคลุมที่เหลือให้ทั้งหมดอยู่แล้ว
  • ชั้นก่อนสองชั้นนี้ หากมีแค่ชั้นเดียวก็จะเป็นการกดดันมากเกินไป จะกลายเป็นว่าต้องการกฎละเอียดจำนวนมาก แต่ถ้าแบ่งเป็น 3 ชั้น ค่อย ๆ เพิ่มความละเอียดมากขึ้น ก็จะทำให้ได้จำนวนกฎน้อยลง

ด้วยโครงร่างแบบนี้ จึงออกแบบกฎเป็นชั้น ๆ ดังนี้:

  • ชั้นที่ 1 กฎสั้น, เน้น bad weight เล็กน้อย, threshold สูง เพื่อคุมจำนวนกฎ
  • ชั้นที่ 2 กฎยาวขึ้น, เน้น good weight เล็กน้อย เพื่อเน้นลดจำนวน error ถึงแม้จะมีการกำจัด hyphen ที่ถูกออกบ้างก็ไม่เป็นไร ยังมีชั้นที่ 3 ช่วยเติมให้, threshold ลดหลั่นลงจากชั้นที่ 1 เพราะกรณีเหลือน้อยลง สามารถปล่อยกฎผ่านได้มากขึ้น
  • ชั้นที่ 3 กฎยาวขึ้นอีก, เน้น bad weight กว่าชั้นที่ 1 ตามระดับความละเอียดของเนื้องาน, threshold ลดหลั่นลงจากชั้นที่ 2
  • ชั้นที่ 4 (รองสุดท้าย) กฎยาวขึ้นอีก, good/bad weight สูสีกัน (แต่ good weight ควรมากกว่า bad weight คล้ายชั้นที่ 2), threshold ควรเป็น 1 (ค่าที่น้อยที่สุด) ตามที่อธิบายไปข้างต้น
  • ชั้นที่ 5 (ชั้นสุดท้าย) กฎยาวขึ้นอีก, bad weight เป็นอนันต์ (ค่าสูง ๆ), threshold เป็น 1 เพื่อให้ทุกกฎทำงาน

Liang บอกว่าไม่มีทฤษฎีอะไรมากกว่านี้อีกแล้ว ที่เหลือต้องทดลอง ทดลอง และทดลอง เพื่อหาพารามิเตอร์ที่ดีที่สุดของข้อมูล ซึ่งผมก็ต้องทดลองปรับค่าต่าง ๆ ทีละนิด หนักเอาการอยู่ จนกระทั่งได้ค่าที่คิดว่าเหมาะที่สุดเท่าที่เจอมาสำหรับข้อมูลพจนานุกรม libthai ที่ใช้แล้ว คือ:

level good wt. bad wt. thres. pats added % good % errors
1 1 2 6 375 90.30 10.61
2 2 1 4 250 88.88 1.61
3 1 3 2 524 96.21 1.66
4 3 2 1 295 95.98 0.00
5 1 5 1 726 100.00 0.00
Total patterns 2170

เทียบกับพารามิเตอร์เดิมที่ใช้ ได้จำนวน pattern ทั้งหมด 3029 ก็ลดจำนวน pattern ลงมาได้ราว 28%

commit เข้า SVN ไปแล้วครับ คิดว่าอีกไม่นานคง release มาให้ทดลองใช้กัน

ป้ายกำกับ: ,

08 มีนาคม 2555

ThaiLaTeX Hyphenation

จากที่ได้ blog ครั้งล่าสุด เกี่ยวกับ ThaiLaTeX ผมก็ได้ออกรุ่นซอฟต์แวร์ทั้งหมดที่เกี่ยวข้องไปแล้วตั้งแต่กลางเดือนกุมภา คือ Fonts-TLWG 0.5.0 และ Fonts-SIPA-Arundina 0.2.0 ซึ่งได้เปลี่ยนชื่อโครงการด้วย แล้วก็ตามด้วย ThaiLaTeX 0.4.7 ในคราวเดียวกัน เผอิญว่าติดธุระส่วนตัวมากจนไม่สามารถหาเวลานั่งเขียน blog ได้

เกี่ยวกับการเปลี่ยนชื่อโครงการฟอนต์ทั้งสองนี้ ก็ด้วยเหตุว่ามีการเปลี่ยนชื่อที่ปลายน้ำหลายจุดไปในทางเดียวกัน ไม่ว่าจะเป็นที่ Debian หรือ CTAN โดยสำหรับ Debian นั้น กลุ่มผู้ดูแลแพกเกจฟอนต์ของ Debian ได้กำหนดวิธีการตั้งชื่อแพกเกจฟอนต์ใหม่ ซึ่งก็ได้รับแรงบันดาลใจมาจาก Fedora อีกต่อหนึ่ง ส่วนที่ CTAN นั้น เขาต้องการชื่อแพกเกจที่สอดคล้องกันกับชื่อ style file ที่ติดตั้ง และไดเรกทอรีที่ติดตั้ง ควรมีเอกภาพเป็นชื่อเดียว ซึ่งก็ได้เลือกชื่อ fonts-tlwg สำหรับโครงการ ThaiFonts-Scalable อีกอย่าง ตอนนี้ linux.thai.net ก็ได้โฮสต์โครงการฟอนต์หลายโครงการ การตั้งชื่อที่กว้างเกินไปอย่าง ThaiFonts-Scalable ย่อมไม่เหมาะสมอีกต่อไป จึงได้เปลี่ยนชื่อเป็น Fonts-TLWG และฟอนต์ชุด Arundina ก็เปลี่ยนเป็น Fonts-SIPA-Arundina ในทำนองเดียวกัน

หลังจากที่เสร็จงานชุดนั้นไป ผมก็ได้นำประเด็นเรื่อง hyphenation ที่ได้ คิดไว้ ขึ้นมาพิจารณา โดยหารือร่วมกับนักพัฒนาในการประชุมระดมสมองโอเพนซอร์สภาษาไทยที่พัทยา เมื่อกลับมาแล้วก็ตกลงใจว่าจะเริ่มเดินหน้าต่อเลย

แนวทางที่คุยกันไว้นั้น เป็นไปได้หลายวิธี:

  • ทำ hyphenation pattern สำหรับ TeX โดยใช้ patgen
  • ปรับ swath ให้แทรก soft hyphen (\- สำหรับ TeX) ด้วย

สำหรับทางเลือกแรกที่ทำ pattern สำหรับ TeX นั้น หากทำสำเร็จจะสามารถใช้กับโครงการอื่น เช่น FOP ของ Apache รวมถึง LibreOffice ด้วย

ผมเริ่มจากทางแรกก่อน โดยอาศัย word list ของ libthai มาแทรกยัติภังค์ที่จุดที่เป็นไปได้ แล้วป้อนเข้า patgen สร้างเป็น hyphenation pattern ออกมา แล้วติดตั้งลงใน TeX ปรากฏว่าผลที่ได้เป็นที่น่าพอใจพอสมควร ดังตัวอย่างเปรียบเทียบการจัดย่อหน้าโดยใช้และไม่ใช้ยัติภังค์:

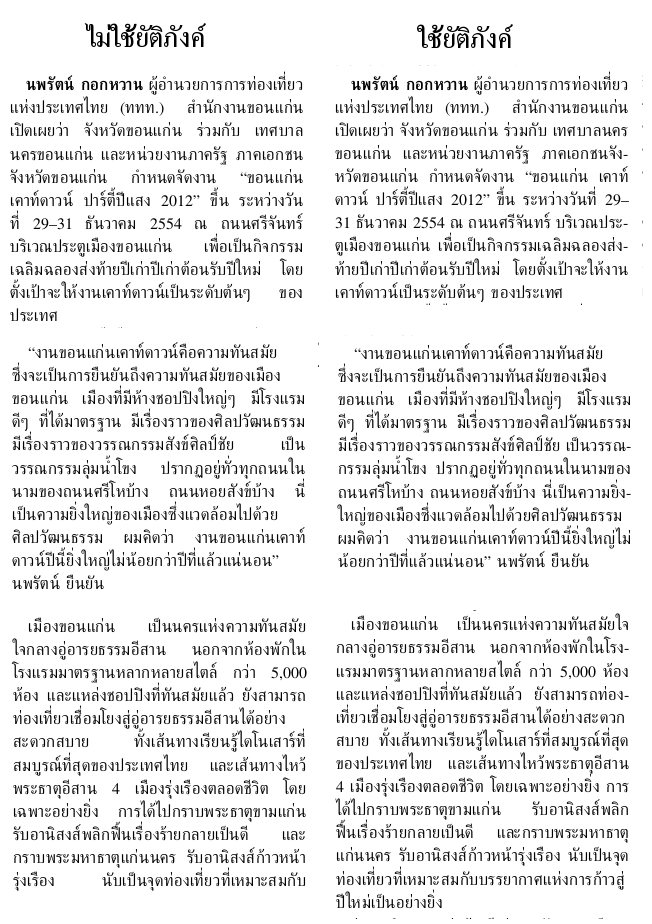
เปรียบเทียบผลจาก hyphenation

จะเห็นว่าช่องไฟที่โบ๋ ๆ ลดน้อยลง และทำให้ย่อหน้ากระชับเข้ามาอีก เมื่อสังเกตจุดตัดบรรทัดก็จะพบว่า TeX คำนวณจุดแบ่งบรรทัดโดยมองภาพรวมทั้งย่อหน้า ไม่ใช่คำนวณทีละบรรทัด

นี่เป็นผลในขั้นแรก ซึ่งได้ commit เข้าใน trunk ของ SVN ของ thailatex แล้ว โดยที่ผมยืมค่าพารามิเตอร์สำหรับ patgen มาจาก วิทยานิพนธ์ชิ้นหนึ่ง โดยยังไม่ได้ปรับละเอียดเองตามข้อมูลที่มี ซึ่งตรงนี้คงหาเวลาทำในโอกาสต่อไป

ป้ายกำกับ: , ,

03 กุมภาพันธ์ 2555

A Butterfly in ThaiLaTeX

๏ มาจะกล่าวบทไป
บั๊กหนึ่งใน ThaiLaTeX เล็กนักหนา
เพียงวูบวับขยับปีกกรีดกรายมา
เกิดลมพาถาโถมโพยมบน ฯ

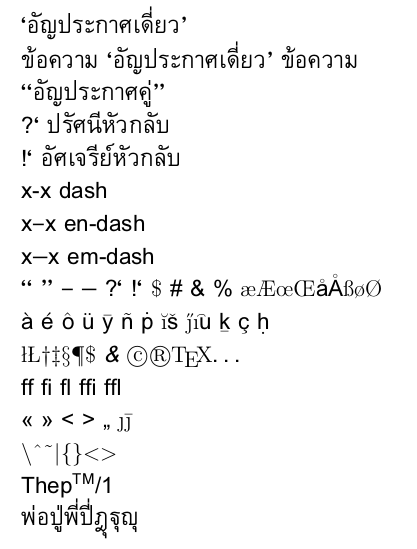
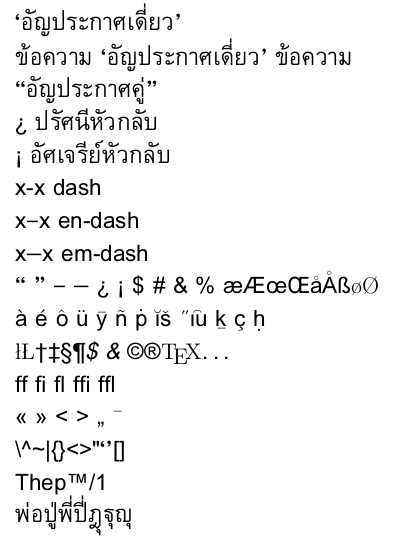
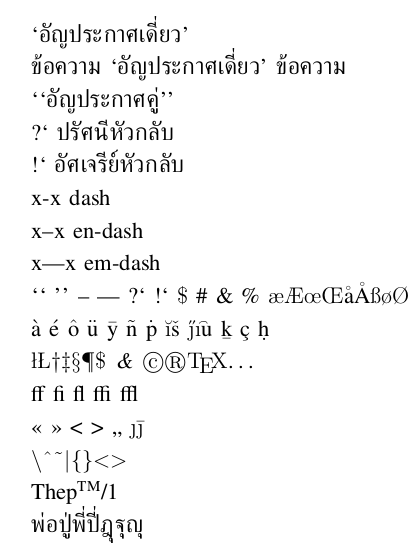
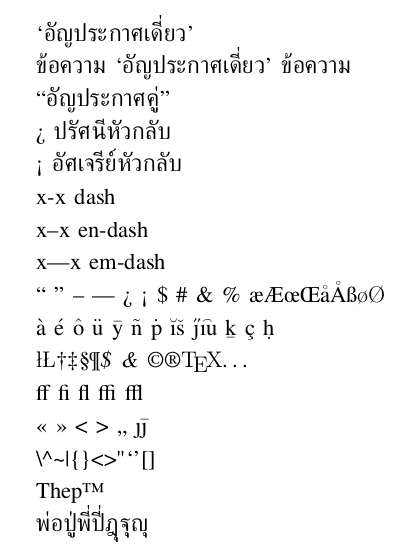
จากที่ได้เขียนถึง ปัญหาอัญประกาศ ใน ThaiLaTeX ไปเมื่อปลายธันวา นับจากวันนั้นถึงวันนี้ เวลาว่างของผมก็หมดไปกับการแก้ ThaiLaTeX และสิ่งที่เกี่ยวข้อง โดยบั๊กนี้ได้กลายเป็นผีเสื้อกระพือปีกที่ทำให้เกิดผลพวงเป็นพายุใหญ่ได้ทีเดียว

เริ่มจาก:

  • พบว่าลำดับ `` และ '' ในเอกสาร ThaiLaTeX ไม่ได้มีการแปลงเป็นอัญประกาศคู่ แต่ยังคงรูปเป็นอัญประกาศเดี่ยวสองตัวเหมือนเดิม ซึ่งพบว่าปัญหาอยู่ที่ฟอนต์
  • ระหว่างตรวจสอบปัญหาในกฎ ligkern ของ virtual font ก็พบว่ามีลำดับอื่นที่ยังไม่มีการแปลงเช่นกัน เช่น ?` (¿), !` (¡), \dag (†), \ddag (‡) ฯลฯ ดังที่กล่าวไปแล้วใน blog ก่อน
  • ขณะทดสอบผลการแก้กฎ ligkern ก็พบว่า swath ไปแทรกรหัสแบ่งคำตรงกลางระหว่างลำดับ `` กลายเป็น `{\wbr}` ในบางกรณี
  • ก่อนจะลงมือแก้ swath ก็ชักทนปวดหัวกับซอร์สที่อ่าน (โคตร) ยากของ swath ไม่ไหว จึงจัดระเบียบซอร์สเสียใหม่ ตั้งแต่ใช้เครื่องมือจัดสไตล์ของซอร์สอัตโนมัติแล้วมาปรับแต่งด้วยมือทีหลัง ปรับเปลี่ยนโครงสร้าง ตัดตัวแปรหรือ member ที่ไม่จำเป็น ซึ่งกลายเป็น commit ชุดใหญ่ คือประมาณ 40 commit ใน 4 วัน ส่งท้ายปีเก่า หลังจากนั้นจึงได้แกะและแก้บั๊กที่ต้องการ และปรับโค้ดต่ออีกนิดหน่อย
  • กลับมาที่ ThaiLaTeX เอง เพื่อจะทดสอบฟอนต์ต่าง ๆ จึงมีการปรับเปลี่ยนเอกสารทดสอบ (teststd.tex) ให้รวมลำดับอักษรพิเศษด้วย แต่เพื่อความสะดวกในการปรับแก้ จึงจัดโครงสร้างเอกสารใหม่เสียก่อนโดยใช้แมโคร แล้วจึงแก้เพิ่ม
  • กลับมาแก้ฟอนต์ที่เหลือต่อ โดยหลังจากที่ทดสอบกับฟอนต์ Norasi ที่มี glyph ค่อนข้างครบแล้ว ก็จำเป็นต้องไล่เพิ่ม glyph พิเศษทั้งหมดที่ lthenc.def ตัวใหม่รองรับในฟอนต์ที่เหลืออีก 11 family ในชุด tlwg ซึ่ง glyph ที่ขาดก็มากบ้างน้อยบ้างแล้วแต่ฟอนต์
  • หลังจากเพิ่ม glyph ที่จำเป็นสำหรับ LaTeX แล้ว ก็จำเป็นต้องเพิ่ม glyph ละตินที่เหลือด้วย มิฉะนั้นการแสดงผลบนเดสก์ท็อปก็จะแหว่งไป ซึ่งปริมาณ glyph ที่เพิ่มนั้นเยอะกว่าชุด LaTeX หลายเท่า
  • การเพิ่ม glyph ละติน มีบางฟอนต์ที่ต้องวาดเพิ่มเอง ไม่สามารถหยิบยืมจากฟอนต์อื่นได้ ก็จำเป็นต้องดูขนาดของเส้นจากอักษรอังกฤษที่มี ซึ่งทำให้พบว่ามีบางฟอนต์ที่เส้นอักษรอังกฤษยังไม่สม่ำเสมอ จึงต้องนั่งปรับเส้น glyph อังกฤษเสียก่อน ได้แก่ฟอนต์ Loma ซึ่งมีการหยิบยืมไปใช้ในฟอนต์ Umpush ด้วย การแก้ครั้งนี้จึงทำให้ฟอนต์ทั้งสองได้เส้นที่สม่ำเสมอยิ่งขึ้นด้วย
  • ระหว่างทดสอบ พบบั๊กในฟอนต์ Loma และ Umpush เมื่อใช้กับเอกสาร LaTeX คือสระบนและวรรณยุกต์จะเยื้องกัน ทำให้คำว่า "ที่" จะวาดไม้เอกและสระอีไม่ตรงแนวกัน ก็แก้บั๊กนี้ในฟอนต์ทั้งสองด้วย

บั๊กตัวแรกที่พบจึงไม่ใช่แมลงธรรมดา แต่เป็นผีเสื้อกระพือปีกด้วยประการฉะนี้

ยังเหลือฟอนต์ชุด Arundina ต้องทำต่ออีกครับ แล้วค่อยออกทั้งชุดพร้อมกันทีเดียว

ป้ายกำกับ: , ,

27 ธันวาคม 2554

ThaiLaTeX wbr, Quotation and Special Characters

หลังจากที่ แยกร่าง ThaiLaTeX เสร็จไปแล้ว ขณะที่พยายามจะทำความสะอาดโค้ดเพื่อเตรียมส่งเข้ารวมใน Babel นั้น ก็ได้ข่าวมาสองชิ้น เป็นข่าวร้ายและข่าวดี

ข่าวร้ายคือโครงการ Babel นั้นอยู่ในสถานะ unmaintained มานานแล้ว ส่งไปตอนนี้ก็ไม่มีใครจัดการให้ แต่ข่าวดีคือ ยังพอมีหวังถ้าสามารถเข้ารวมใน TeX Live ได้ และได้รับคำแนะนำจากผู้ดูแล TeX Live ให้ปรับปรุงเรื่องการจัดโครงสร้างของแพกเกจ

ดังนั้น รายการเปลี่ยนแปลงของ ThaiLaTeX และฟอนต์ทั้งสองชุดในช่วงที่ผ่านมา จึงเป็นการจัดโครงสร้างแพกเกจสำหรับ CTAN เสียใหม่ให้ตรงตามข้อกำหนด TDS มากขึ้น โดยของเดิมนั้นเพียงแค่ใช้ได้ในระดับหนึ่ง แต่ยังต้องปรับปรุงอีกเพื่อให้ทำงานกับสคริปต์ต่าง ๆ ของ TeX Live ได้ดีขึ้น

เสร็จเรื่องจัดโครงสร้างแล้ว ก่อนจะออกรุ่นใหม่ก็กลับมาทำความสะอาดต่อ ก็ปรากฏว่าพบประเด็นอีก 2 ประเด็นที่เป็นจุดบกพร่องอยู่

1. การเว้นช่องไฟระหว่างคำ

ในคำสั่ง \wbr ปัจจุบันนั้น ได้ดัดแปลงจากแค่เป็นช่องว่างที่ไม่มีความกว้างธรรมดา ให้กลายเป็น glue ที่สามารถยืดได้ เพื่อช่วยในการจัด justified text ในคอลัมน์แคบ โดยให้มาแทรกช่องว่างระหว่างคำด้วย เนื่องจากภาษาไทยใช้อักขระเว้นวรรคน้อยกว่าภาษาอังกฤษ แต่จากการสังเกตเอกสารที่ใช้คอลัมน์แคบ ปรากฏว่าทำให้หลายจุดกลายเป็นการเว้นช่องว่างระหว่างคำเหมือนในหนังสือเรียนชั้นประถม ซึ่งดูไม่สวยงามเลย และในบรรทัดที่ตัดคำไม่ถูก เช่นบรรทัดที่มีชื่อคน ก็จะเป็นการเปิดเผยจุดตัดคำที่ผิดไปด้วย แต่ครั้นจะไม่ยืด \wbr ก็จะทำให้ช่องว่างห่างมาก และในบรรทัดที่ไม่มีช่องว่างเลย บรรทัดก็จะ rag ด้านขวา (แต่สังเกตว่าการไม่ยืดช่องไฟทำให้เส้นหมึกของตัวหนังสือสม่ำเสมอน่าอ่านกว่า)

\wbr แบบยืดได้ \wbr แบบยืดไม่ได้

วิธีแก้ที่นิยมที่สุดในงานพิมพ์ภาษาไทยคือ ใช้ letter-spacing คือการกระจายช่องไฟลงไประหว่างอักขระ ซึ่งวิธีนี้ก็มีข้อเสียเหมือนกัน คือในกรณีที่ต้องชดเชยช่องว่างมาก (ซึ่งในกรณีแยกคำทำให้เห็นคำแยกเป็นคำ ๆ) ช่องไฟที่แทรกลงไปจะทำให้อักขระแยกห่างจากกัน ทำให้อ่านยากอยู่ดี เพราะตามหลักการทำงานของสมองขณะอ่านนั้น สมองจะรับรู้คำต่าง ๆ เป็นรูปภาพของกลุ่มอักขระมากกว่าจะไล่สะกดเรียงตัว แต่เมื่อภาพถูกยืดออกมากเกินไป ก็จะทำให้การรับรู้รูปคำช้าลง

อย่างไรก็ดี เรื่อง letter-spacing นั้นทำใน LaTeX ได้ยาก เพราะนอกจากจะถือเป็นหนึ่งใน bad practice ในเชิง typography แล้ว ยังทำให้มีปัญหากับการจัดการ ligature (ff, fi, fl, ffi, ffl) อีกด้วย ทำให้ Knuth ไม่สนใจสนับสนุนวิธีการนี้ใน TeX และหากเราจะจัดการกับภาษาไทย ก็ต้องจัดการภาษาอังกฤษด้วย เพื่อให้ช่องไฟสมดุลกัน และคงต้องไปรบรากับนัก typography อีกเยอะ

สิ่งที่จะช่วยได้อีกอย่างคือการรองรับ hyphenation ซึ่งจะทำให้จุดแบ่งบรรทัดละเอียดขึ้น ลดปัญหาการชดเชยช่องไฟลง ซึ่ง TeX จะมีอัลกอริทึมในการตัดบรรทัดไม่ให้มี hyphenation ติดต่อกันมากเกินไปอยู่แล้ว

ก็ต้องวิจัยกันต่อไป ว่าสามารถเขียน hyphenation pattern สำหรับภาษาไทยออกมาได้หรือไม่ หรือจะใช้พจนานุกรมช่วยโดยเพิ่มความสามารถใน swath แต่เฉพาะหน้านี้ ผมได้ตัดเรื่องการยืดช่องไฟของ \wbr ออกแล้ว กลับไปใช้ช่องไฟแบบไม่มีช่องว่างเหมือนเดิม

2. อัญประกาศและเครื่องหมายพิเศษต่าง ๆ

ผมได้สังเกตเห็นมาระยะหนึ่งแล้ว ว่าอัญประกาศคู่ในเอกสาร LaTeX ภาษาไทยมันดูห่าง ๆ โดยเฉพาะฟอนต์นรสีห์จะเห็นได้ชัด พอเปิด PDF ที่ได้แล้วใช้เมาส์เลือกดู ก็พบว่ามันไม่ได้แปลง `` หรือ '' ให้เป็นอัญประกาศคู่ตัวเดียวเลย ยังคงเป็นอัญประกาศเดี่ยวสองตัวซ้อนกันอยู่เหมือนใน input แกะไปแกะมาก็พบว่าเป็นบั๊กในกฎ ligkern วิธีแก้นั้นมีหลายวิธี ได้ผลครบถ้วนไม่เท่ากัน เนื่องจากปัจจุบันสามารถใช้ UTF-8 ในเอกสารได้ ทำให้สามารถป้อนอักขระยูนิโค้ดของอัญประกาศลงไปตรง ๆ ได้เหมือนกัน แก้ไปแก้มาก็พบ trick ที่ทำให้ใช้งานได้ทุกกรณี ซึ่งแก้เพียง 3 บรรทัดเท่านั้น

การแก้ไขนี้มีผลทำให้ลำดับ ?` และ !` ซึ่ง TeX กำหนดให้แปลงเป็น ¿ และ ¡ ตามลำดับกลับมาทำงานถูกต้องด้วย และเมื่อได้ตรวจสอบลำดับอื่น ๆ ของ TeX ก็พบว่ามีหลายตัวที่ยังไม่ได้กำหนดใน encoding LTH ทำให้ TeX ต้องสำรองใช้ glyph จาก encoding OT1 หรืออื่น ๆ แทน ซึ่งรวมถึงเครื่องหมายพื้นฐานอย่าง $ ด้วย ทำให้รูปแบบตัวอักษรดูไม่กลมกลืนกันเพราะมาจากคนละฟอนต์ และเพื่อแกล้งให้มันต่างกันมากเพื่อให้สังเกตได้ง่ายระหว่างทดสอบ ก็ได้ทดลองใช้ฟอนต์ garuda ผ่านคำสั่ง \usefont ไม่ใช่ \sffamily เพื่อให้ glyph ที่สำรองนั้นไปดึงมาจาก roman shape ให้มันต่างจาก san serif ของ garuda

รูปข้างล่างนี้แสดงการเปรียบเทียบก่อนและหลังการแก้ ทั้งกรณีอัญประกาศและเครื่องหมายพิเศษ:

Garuda ก่อน Garuda หลัง

กับฟอนต์นรสีห์:

Norasi ก่อน Norasi หลัง

จะเห็นว่าไม่ได้กู้อักขระละตินกลับมาทั้งหมด เนื่องจากช่องว่างในตารางอักขระมีจำกัด จึงเลือกเอาเฉพาะที่น่าจะได้ใช้บ่อยเท่านั้น หลังจากแก้แล้ว อักขระละตินนอกช่วง ASCII ที่สามารถใช้ใน LTH ได้ ได้แก่ ?` (¿), !` (¡), \dag (†), \ddag (‡), \S (§), \P (¶), \copyright (©), \textregistered (®), \texttrademark(™), \ae (æ), \AE (Æ), \oe (œ), \OE (Œ), \ss (ß), \i (ı), \j (ȷ) ส่วนอักขระ accent ทั้งหลาย ยังคงใช้การผสม accent ของ TeX ตามปกติ (เช่น \'e = é)

แต่งานยังไม่จบครับ ปัญหาคือไม่ใช่ทุกฟอนต์ที่มี glyph เหล่านี้ครบ ยังต้องไล่เพิ่ม glyph ก่อน (เช่น ตัวอย่างของ garuda จะเห็นว่า dotless j หาย) กว่าจะเสร็จคงปีหน้า :-)

Update (2011-12-28 09:28+0700): เพิ่มโค้ด LaTeX สำหรับอักขระละตินที่ใช้เพิ่มได้ เพื่อความชัดเจน

ป้ายกำกับ: ,

hacker emblem