Theppitak's blog

My personal blog.

25 กรกฎาคม 2568

Tai Tham Updated, Thai Noi Revisited

Update งานอักษรอีสาน

Khottabun กับอักษรธรรมแบบไร้ USE

หลังจากการวิเคราะห์ทางเลือกต่างๆ สำหรับอักษรธรรมไป 2 blog (Lao Tham Font vs USE และ To USE or Not to USE for Lao Tham) และได้ตัดสินใจ หลีกเลี่ยง USE โดยยอมทิ้ง MS Word ไว้ข้างหลัง ก็ได้ implement ใน fonts-khottabun ตามนั้น ตั้งแต่ commit a0389bd จนถึง commit 1c73c80 โดยปรับ major version ของฟอนต์ขึ้นเป็นรุ่น 003 สำหรับอักษรธรรมแบบไม่ใช้ USE

Keyboard Layout อักษรธรรมบน Windows

ถัดมาคือ ผังแป้นพิมพ์อักษรธรรมบน Windows ในรูปของซอร์ส KLC สำหรับสร้างเป็นผังแป้นพิมพ์ด้วย Microsoft Keyboard Layout Creator (MSKLC) 1.4 ซึ่งจะ build เป็น DLL พร้อมโปรแกรม setup

ประเด็นปลีกย่อยของผังนี้คือ Windows กำหนดให้ผังแป้นพิมพ์ต้องผูกติดกับโลแคล (locale) ซึ่งกำหนดด้วยภาษาและดินแดน ตรงนี้เป็นปัญหาโดยนิยามอยู่ เพราะอักษรธรรมสามารถใช้เขียนได้หลายภาษา ไม่ว่าจะไทย ลาว ไทลื้อ ไทขึน หรือคาถาบาลี-สันสกฤต แต่ Windows จะบังคับให้เราเลือกเพียงภาษาเดียวมาประกอบกับดินแดนที่เป็นถิ่นของภาษาที่ใช้ โดยห้ามใช้ซ้ำกับผังอื่นในโลแคลนั้นๆ ด้วย ประเด็นคือ:

  • โลแคลต่างๆ มักมีผังแป้นพิมพ์อยู่แล้ว ถ้าไม่ต้องการซ้ำก็ต้องสร้างโลแคลใหม่สำหรับอักษรธรรม แต่จะกำหนดโลแคลด้วยภาษาอะไร ในเมื่ออักษรธรรมสามารถใช้เขียนได้หลายภาษา?
  • สมมุติว่าเราเลือกสร้างโลแคลภาษาลาวถิ่นไทย (lo-TH) ด้วย Microsoft Locale Builder แต่ปัญหาคือ เราไม่สามารถเลือกบล็อคยูนิโคดของอักษรธรรมให้กับโลแคลใหม่นี้ได้ เนื่องจาก Microsoft กำหนดตัวเลข enum ให้กับบล็อคยูนิโคดต่างๆ แต่ยังไม่ได้กำหนดเลขสำหรับอ้างให้กับบล็อคอักษรธรรม!
  • ในเมื่อสร้างโลแคลเองไม่ได้ วิธีแก้ขัดจึงเป็นการเลือกโลแคลอะไรก็ได้ที่ไม่ซ้ำกับชุดผังแป้นพิมพ์ที่เราใช้ เช่น ใช้ th, en ไม่ได้ เพราะจะซ้ำกับสองผังหลักที่เราใช้ และผมก็จิ้มเอาโลแคลมลยาฬัมในอินเดีย (ml-IN) โดยไม่มีเหตุผลใดๆ มากไปกว่าการแก้ขัด เวลาจะป้อนอักษรธรรมบน Windows ผู้ใช้ก็สลับแป้นพิมพ์ไปที่ภาษามลยาฬัม
  • อันที่จริง สิ่งที่เราต้องการมากกว่าในกรณีนี้คือการอ้างถึง อักษร (script) ตรงๆ ไปเลย แต่การออกแบบของ Windows ยังไม่เอื้อขนาดนั้น

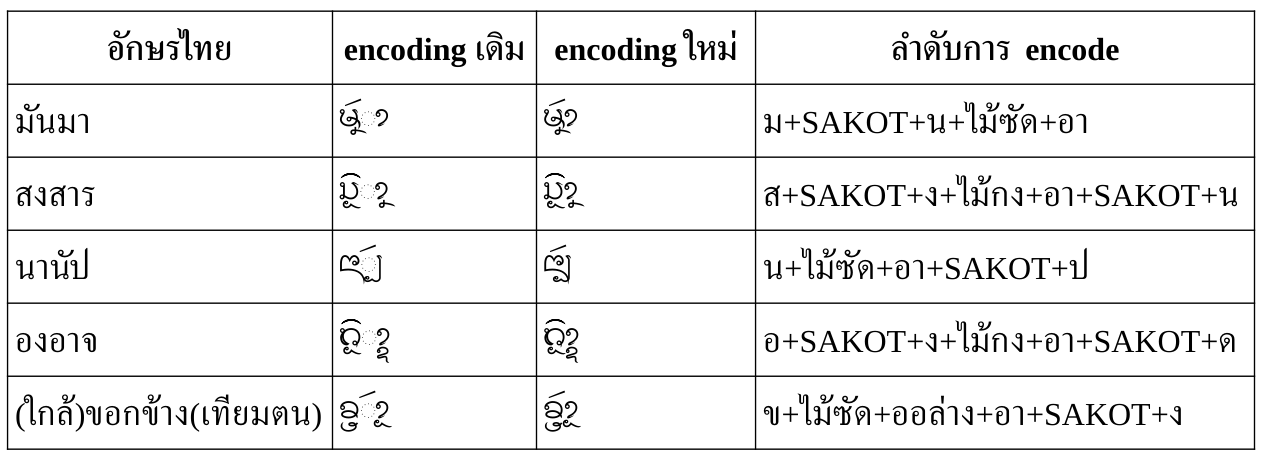
อย่างไรก็ดี เราก็ได้ผังแป้นพิมพ์อักษรธรรมที่ทำงานได้บน Windows โดยเป็นเพียงผังปุ่มจริงๆ ยังไม่มีการตรวจหรือสลับลำดับอะไร ผู้ใช้ต้องป้อนตามลำดับยูนิโคดเป๊ะๆ เช่น ᨸᩮᩢ᩠ᨶ (เป็น) ก็ต้องป้อนเป็น ป + เอ + ไม้ซัด + SAKOT + น

อักษรไทยน้อย

แม้อักษรไทยน้อยจะเรียบง่ายกว่าอักษรธรรม แต่กลับมีรายละเอียดปลีกย่อยมากกว่า ทั้งเรื่องความหลากหลายของชุดอักษรที่ใช้ การควบอักษรติดกัน การยืมตัวห้อยตัวเฟื้องจากอักษรธรรมตามแต่ผู้จารึกจะเลือกใช้ ดังที่ผมได้เคย สรุปประเด็น ไว้ โดยยังไม่ตกลงว่าจะเลือก implement แบบไหน

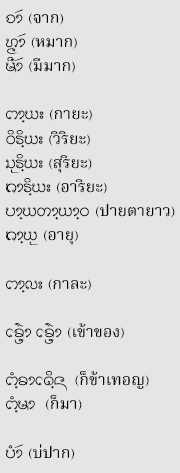
เมื่อหลายปีก่อน ในระหว่างที่ทำไปศึกษาไปนั้น ผมเลือกที่จะเติมอักขระลงในช่องที่ยังว่างอยู่ของบล็อคยูนิโคดอักษรลาว ไม่ว่าจะเป็นตัวเฟื้องหรือตัวควบต่างๆ แต่ยิ่งพบอักขระที่ต้องเพิ่มรหัสมากขึ้นจากการอ่านจารึก ก็ยิ่งเห็นว่ามันไม่ใช่วิธีที่ดีในระยะยาว

ตอนนี้ได้โอกาสมาปัดฝุ่น โดยบล็อคยูนิโคดลาวเองก็มีมีการเพิ่มอักขระสำหรับเขียนภาษาบาลีตามแบบพุทธบัณฑิตสภา จึงได้พิจารณาทางเลือกต่างๆ ใหม่

เริ่มจากตรวจสอบความคืบหน้าใน Unicode ของอักษรไทยน้อย ซึ่ง ข้อมูลใน ScriptSource ของ SIL ได้บันทึกรายละเอียดไว้ โดยสถานะล่าสุดคือ ยังไม่กำหนดใน Unicode ส่วนกระบวนการเท่าที่ผ่านมาคือ

2018-01-02 Request to Add Thai Characters — Nitaya Kanchanawan (WG2 N4927, L2/18-041)
เป็นข้อเสนอขอเพิ่มอักขระไทยน้อยลงในบล็อคอักษรไทย! โดยเป็นงานที่เกี่ยวเนื่องกับการกำหนดมาตรฐานการถอดอักษรไทยน้อยเป็นอักษรโรมันที่ราชบัณฑิตยสภาได้เสนอเข้าสู่ ISO/IEC โดยได้รับความเห็นว่าควรกำหนดรหัสอักขระก่อน แต่ไม่ทราบว่าด้วยเหตุผลใด ราชบัณฑิตยสภาถึงได้เสนอให้เพิ่มอักขระในบล็อคอักษรไทยแทนที่จะเป็นบล็อคอักษรลาวที่อยู่ในสายวิวัฒนาการโดยตรง
2018-01-19 Information and documentation - Transliteration of scripts in use in Thailand - Part 1: Transliteration of Akson-Thai-Noi — TC46 / WG3 (WG2 N4927A, L2/18-042)
เป็นร่างมาตรฐานการถอดอักษรไทยน้อยเป็นอักษรโรมันที่เป็นต้นเรื่อง ตัวเอกสารต้องใช้รหัสผ่านในการเข้าถึง และไม่เกี่ยวข้องกับเรื่องรหัสอักขระโดยตรง ผมจึงไม่ใส่ลิงก์ไว้
2018-01-19 Results on ISO CD 20674-1: Information and documentation - Transliteration of scripts in use in Thailand - Part 1: Transliteration of Akson-Thai-Noi — TC46 Secretatriat (WG2 N4927B, L2/18-043)
ผลการโหวตร่างมาตรฐานการถอดอักษรไทยน้อยของคณะกรรมการ เห็นชอบ 16, เห็นชอบโดยมีข้อคิดเห็น 2, ไม่เห็นชอบ 1, งดออกเสียง 19
2018-02-20 Thai-Noi Transliteration — Martin Hosken (WG2 N4939, L2/18-068)
เป็นความเห็นจากคุณ Martin Hosken ผู้เชี่ยวชาญจาก SIL โดยสรุปเห็นว่าอักษรไทยน้อยเข้ากันได้กับอักษรธรรมมากกว่าอักษรไทย
2018-02-28 Towards a comprehensive proposal for Thai Noi / Lao Buhan script — Ben Mitchell (L2/18-072)
เป็นความเห็นจากคุณ Ben Mitchell ผู้เชี่ยวชาญอีกท่านหนึ่ง โดยมีผู้ร่วมให้ข้อมูลคือ Patrick Chew, ผมเอง และ อ.ประพันธ์ เอี่ยมวิริยะกุล โดยสรุปเห็นว่าควรเพิ่มอักขระไทยน้อยในบล็อคอักษรลาว โดยเพิ่มเติมจากอักษรลาวบาลีของพุทธบัณฑิตสภาอีกที และได้เสนอทางเลือกต่างๆ ดังที่ผมได้สรุปไว้ แต่ยังไม่ระบุว่าจะเลือกวิธีการไหน
Recommendations to UTC #155 April-May 2018 on Script Proposals (L2/18-168) (อยู่ที่ข้อ 6.) และบันทึกการประชุมของ UTC #155 (L2/18-115) (อยู่ที่ข้อ D.8.1 และ D.8.3)
สรุปข้อแนะนำของคณะกรรมการว่าอักษรไทยน้อยไม่ใข่ส่วนขยายของอักษรไทย และผู้เสนอร่างอักษรไทยน้อย (หมายถึง อ.นิตยา กาญจนวรรณ จากราชบัณฑิตยสภา) ควรนำข้อมูลในเอกสารของคุณ Ben Mitchell ข้างต้นไปใช้ประกอบการร่างด้วย โดยมอบให้ Deborah Anderson ร่างเอกสารแจ้งเจ้าของร่าง ซึ่งก็คือเอกสาร L2/18-070

แล้วกระบวนการทั้งหมดก็หยุดอยู่ที่รอการดำเนินการของราชบัณฑิตยสภาต่อจากนั้น

สรุปว่ายังไม่มีมาตรฐาน Unicode อักษรไทยน้อยเกิดขึ้น ถ้าจะ implement ตอนนี้ก็เป็นเพียงตุ๊กตาเท่านั้น

จากทางเลือกต่างๆ ที่มี ผมพิจารณาเลือกเองไปก่อนอย่างนี้:

  • Conjunct หรือการสังโยคพยัญชนะด้วยตัวห้อย/ตัวเฟื้อง ใช้พินทุ (U+0EBA LAO SIGN PALI VIRAMA) ตามด้วยพยัญชนะที่จะสังโยค ยกเว้นกรณีที่มีรหัสอยู่แล้ว คือ ล ห้อย (U+0EBC) และ ย เฟื้อง (U+0EBD) ก็ใช้รหัสนั้นๆ ไปเลย
  • Ligature หรือตัวแฝด หรืออักษรควบ ใช้ U+200D ZERO WIDTH JOINER (ZWJ) เชื่อมพยัญชนะ ยกเว้นกรณีที่มีรหัสอยู่แล้ว คือ U+0EDC (ໜ), U+0EDD (ໝ) ก็ใช้รหัสนั้นๆ ไปเลย
  • สระออย กำหนดอักขระใหม่ในช่องที่ยังว่างอยู่ คือ U+0EBE เพื่อให้เป็นวิธีที่สอดคล้องกับอักษรธรรม (อีกวิธีที่ไม่ต้องกำหนดอักขระใหม่คือใช้ พินทุ + ຢ แต่จะเป็นวิธีที่แปลกแยกจากอักษรธรรม)

เมื่อเลือกวิธีนี้แล้ว ก็ปรับเปลี่ยนทั้งในฟอนต์ Khottabun และในระบบป้อนข้อความ Lanxang ดังนี้:

  • fonts-khottabun: detach glyph ตัวห้อย/ตัวเฟื้องและตัวควบทั้งหมดจากรหัสอักขระ แล้วสร้างกฎ 'ccmp' TN conjuncts และ 'ccmp' TN subjoins เพื่อเข้าถึง glyph เหล่านี้ผ่านพินทุและ ZWJ ตามลำดับ พร้อมกับปรับรุ่น major ของฟอนต์เป็นรุ่น 004 (commit cc4935a)
  • lanxang: ตัดกระบวนการแปลง พินทุ + พยัญชนะ เป็นอักขระตัวห้อย/ตัวเฟื้อง และ พยัญชนะ + ZWJ + พยัญชนะ เป็นอักขระตัวควบ ทั้งหมด (ทิ้ง sequence ประกอบไว้อย่างนั้นในข้อความเลย แล้วให้ฟอนต์จัดการตอน render) ยกเว้นการควบ ໜ,ໝ เพื่ออำนวยความสะดวก (commit f0645b1) แต่ก็ยังป้อน ໜ, ໝ โดยตรงได้ด้วย level 3 เช่นกัน
  • lanxang: เพิ่มผังแป้นพิมพ์อักษรไทยน้อยสำหรับ Windows ด้วย (commit cce81cd)

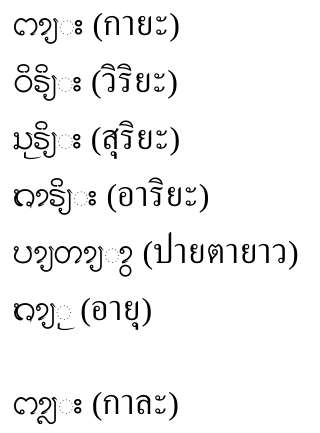
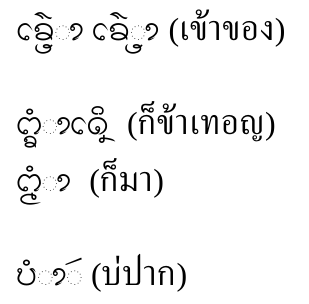
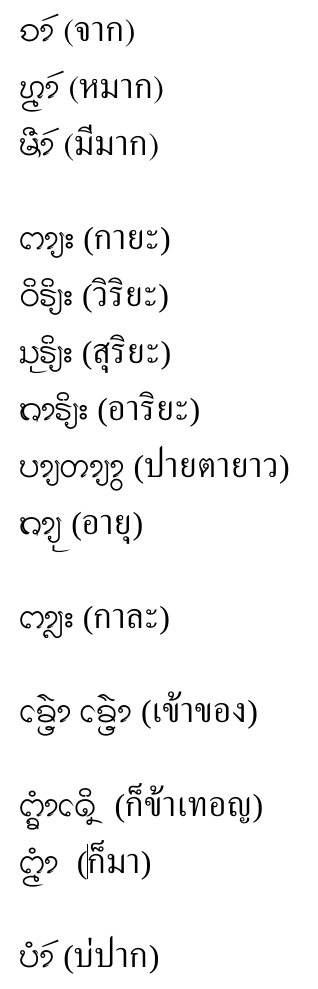
พร้อมกันนี้ก็แปลงวิธีลงรหัสอักขระไทยน้อยในตัวอย่างการปริวรรตทั้งหลายด้วย (พญาคันคาก, ฮีตคองคะลำ, บูชาพญานาค, นกกระจอก)

ป้ายกำกับ: , , , ,

06 เมษายน 2568

To USE or Not to USE for Lao Tham

จาก blog ที่แล้ว ผมได้เล่าถึงการรองรับอักษรธรรมในปัจจุบันที่ text shaping engine ต่างๆ หันมาใช้ Universal Shaping Engine (USE) ตามข้อกำหนดของไมโครซอฟท์ โดย USE เองเป็น engine ครอบจักรวาลที่มีการจัดการภายในตามคุณสมบัติของอักขระ Unicode เช่น การสลับสระหน้ากับพยัญชนะต้นสำหรับอักษรตระกูลพราหมี และเรียกใช้ OpenType feature ต่างๆ ในฟอนต์ตามลำดับที่กำหนดไว้

และการจัดการภายในของ USE ก็ทำให้มีข้อเสนอที่จะปรับโครงสร้างการลงรหัสข้อความอักษรธรรมเพื่อให้ทำงานกับ USE ได้ แต่มันก็ยังไม่เข้าที่เข้าทางนัก จึงเกิดแนวคิดที่จะหลบเลี่ยง USE แล้วทำทุกอย่างเองในฟอนต์ แต่ไปติดปัญหาที่ MS Word ที่ไม่ยอมให้หลบได้ง่ายๆ ทำให้เราอยู่บนทางแยกที่ต้องเลือกว่าจะใช้ USE ที่ยังไม่เข้าที่ หรือจะเลี่ยง USE ไปทำทุกอย่างเองโดยทิ้ง MS Word ไว้ข้างหลัง

blog นี้ก็จะวิเคราะห์ต่อ ว่าทางเลือกแต่ละทางมีข้อดีข้อเสียอย่างไร

Encoding แบบใหม่

ตามข้อเสนอในเอกสาร Structuring Tai Tham Unicode เมื่อตัดรายละเอียดที่อักษรธรรมลาว/อีสานไม่ใช้ออกไป ก็พอจะสรุปลำดับอักขระในข้อความได้เป็น:

  S ::= CC (Vs | Vf)?

โดยที่ CC คือ consonant cluster พร้อมสระหน้า/ล่าง/บน วรรณยุกต์ สระหรือตัวสะกดปิดท้าย

  CC ::= C M? V? T? F?

  C ::= [<ก>-<ฮ><อิลอย>-<โอลอย><แล><ส_สองห้อง><ตัวเลข>] | <ห><SAKOT>[<ก>-<ม>]

  M ::= <ระวง>? <ล_ล่าง>? (<SAKOT><ว>)? (<SAKOT><ย>)?

  V ::= Vp? Vb? Va? 
  Vp ::= [<เอ>-<ไม้ม้วน>] // สระหน้า
  Vb ::= [<อุ>-<อู><ออ_ล่าง>] // สระล่าง
  Va ::= [<อิ>-<อือ><ไม้กง><ไม้เก๋าห่อนึ่ง>][<ไม้ซัด><ไม้กั๋ง>]? // สระบน

  T ::= [<ไม้เอก>-<ไม้โท>]

  F ::= Fs? [<ละทั้งหลาย><ไม้กั๋งไหล><ง_บน><ม_ล่าง><บ_ล่าง><ส_ล่าง><ไม้กั๋ง>]? (<SAKOT> S)?
  Fs ::= [<อ><ส_สองห้อง><ออย>] | <SAKOT>[<ก>-<ฬ>] // อ ของสระเอือ หรือ ตัวสะกด

สังเกตว่ามี recursion ใน F เพื่อแทนลูกโซ่ของพยางค์ในคำบาลีด้วย

ต่อจาก CC ก็จะตามด้วยสระกินที่ (spacing vowels) ซึ่งแบ่งเป็นสระมีตัวสะกด (Vs) และสระไม่มีตัวสะกด (Vf)

สำหรับสระมีตัวสะกด Vs คือสระอาหรือสระอำ (สระอำในอักษรธรรมไม่ได้มีรหัสอักขระเฉพาะเหมือนอักษรไทย แต่แทนด้วยสระอาตามด้วยไม้กั๋ง (นิคหิต) ความจริงอาจนับไม้กั๋งเป็นตัวสะกดในสระอำก็ได้ แต่กฎนี้พยายามจัดการสระอากับสระอำไปด้วยกัน กลายเป็นว่าสระอำก็ยังมีตัวสะกดได้อีก) พร้อมตัวสะกด Fs (ถ้ามี)

  Vs ::= AV Fs?
  AV ::= [<อา><อาสูง>] <ไม้กั๋ง>? // สระอา สระอำ

ส่วนสระไม่มีตัวสะกด Vf ในตัวเนื้อหาของร่างฯ ได้บรรยายถึงสระเอาะและสระเอือะ แต่ในสรุปส่วนท้ายดูจะลืมสระเอาะไป และยังจัดการ อ ของสระเอือะซ้ำซ้อนกับใน Fs อีก

  Vf ::= <อ>? <อะ> // วิสรรชนีย์ของสระเอือะ

Encoding แบบ USE

แม้ encoding แบบใหม่ที่เสนอมีจุดมุ่งหมายเพื่อให้วาดแสดงด้วย USE แต่เมื่อลองใช้กับ USE จริงกลับยังมี dotted circle เกิดขึ้นในหลายกรณี ซึ่งจากการทดลองก็พอจะสังเกตลักษณะของ USE ที่ต่างจากโครงสร้างที่เสนอในร่างดังนี้:

  • ลำดับสระใน V สระบนมาก่อนสระล่าง ไม่ใช่ตามหลังสระล่างอย่างในร่างฯ ดังนั้นจึงอาจปรับกฎเป็น:
      V ::= Vp? Va? Vb?
    
  • วรรณยุกต์อยู่หน้าสระกินที่ไม่ได้ แต่ตามหลังได้ และต้องอยู่ก่อนตัวสะกด ดูเหมือน USE จะนับ Vs เป็นส่วนหนึ่งของ V:
      V ::= Vp? Va? Vb? Vs?
    
    ซึ่งถ้าเป็นเช่นนั้น ก็หมายความว่า USE ก็ยังต้องการการ reorder ให้วรรณยุกต์ไปอยู่ในตำแหน่งก่อนหน้าสระกินที่เพื่อให้สามารถซ้อนบนพยัญชนะได้ด้วย มันจะกลายเป็นความซับซ้อนเกินจำเป็นน่ะสิ

หลักการสำหรับการป้อนข้อความ

สมมติว่าเราใช้ encoding แบบ USE เราจะมีหลักในใจอย่างไร? เราจะใช้ลำดับการพิมพ์แบบที่เราเคยใช้กับอักษรไทยไม่ได้อีกแล้ว เพราะมันคือการ encode แบบกึ่ง visual ไม่ว่าเขาจะยืนยันที่จะเรียกว่า logical order ยังไงก็ตาม แต่ลำดับการ encode นี้จะไม่ตรงกับลำดับการสะกดคำเสมอไป มันเน้นให้เรียงพิมพ์ได้เป็นหลัก! โดยมีลำดับแบบที่เรียกว่า logical order มาหลอกให้งงเล่น

หลักการคือ

  1. ละทิ้งลำดับการสะกดในใจไว้ก่อน พิจารณารูปร่างของข้อความที่ต้องการ แล้ว encode ตามกฎในข้อถัดๆ ไป
  2. ผสมตัวห้อย ตัวเฟื้อง หรือระวง กับพยัญชนะต้นก่อน โดยมากเป็นตัวควบกล้ำ
  3. ตามด้วยสระ โดยถ้ามีสระหลายตัว ให้วางสระตามลำดับ หน้า, บน, ล่าง, ขวา
  4. ตามด้วยวรรณยุกต์
  5. ตามด้วยตัวสะกด ซึ่งอาจเป็นตัวห้อย, ตัวเฟื้อง, ไม้กั๋ง, ง สะกดบน, หรือไม้กั๋งไหล
  6. ถ้ามีการเชื่อมพยางค์เป็นลูกโซ่แบบบาลี ก็นับตัวสะกดเป็นพยัญชนะต้นของพยางค์ถัดไปแล้วใส่สระตามได้เลย

ความไม่ปกติของลำดับ

หลักการที่ว่าไปก็ดูปกติดีนี่? แต่ความซับซ้อนของอักษรธรรมทำให้มันไม่ตรงไปตรงมาอย่างนั้น ต่อไปนี้คือกรณีต่างๆ ที่ฝืนความรู้สึก อย่างน้อยก็ในระยะแรก

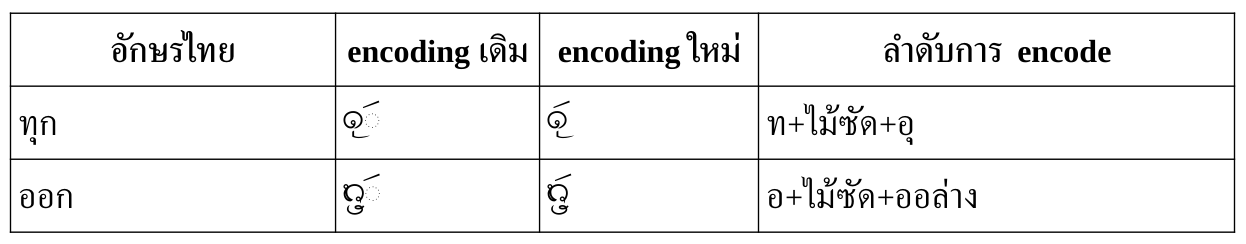
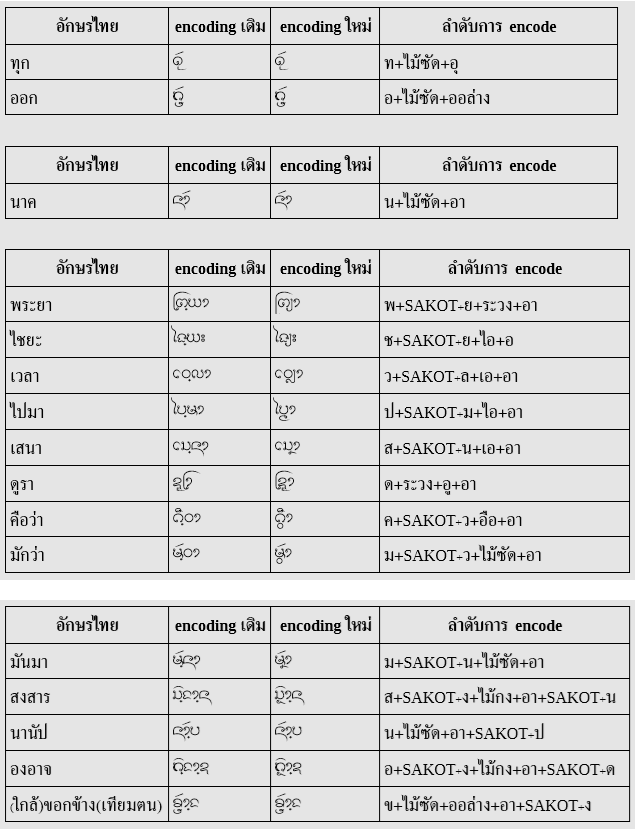
การสะกดแม่กกด้วยไม้ซัด

ไม้ซัดถือว่าเป็นสระบน (Va) ในกฎ ซึ่ง encoding ในร่างฯ สามารถตามหลังสระล่าง (Vb) ได้ แต่ตาม encoding ของ USE ต้องมาก่อนสระล่าง ดังนั้น เมื่อไม้ซัดทำหน้าที่เป็นตัวสะกดแม่กก จึงต้องใช้ลำดับที่ตัวสะกดมาก่อนสระ ไม่ใช่สระมาก่อนตัวสะกด

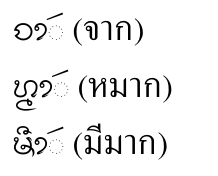
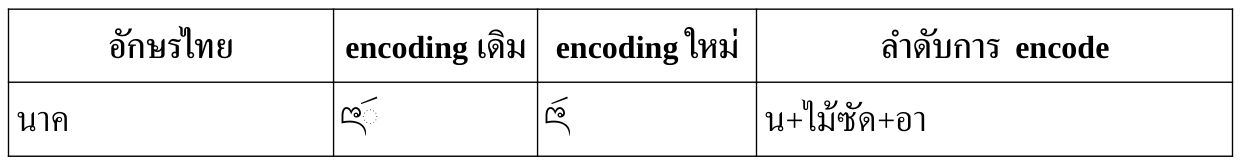
แต่ก็จะมีกรณีที่ไม่สามารถ encode ได้ ไม่ว่าจะตามร่างฯ หรือตาม USE คือเมื่อเป็นตัวสะกดของสระอา

อาจจะยกเว้นคำว่า นาค ที่สามารถซ่อนลำดับไว้ภายใต้รูปเขียนพิเศษได้

เมื่อมีตัวห้อย/ตัวเฟื้องหรือสระระหว่าง cluster

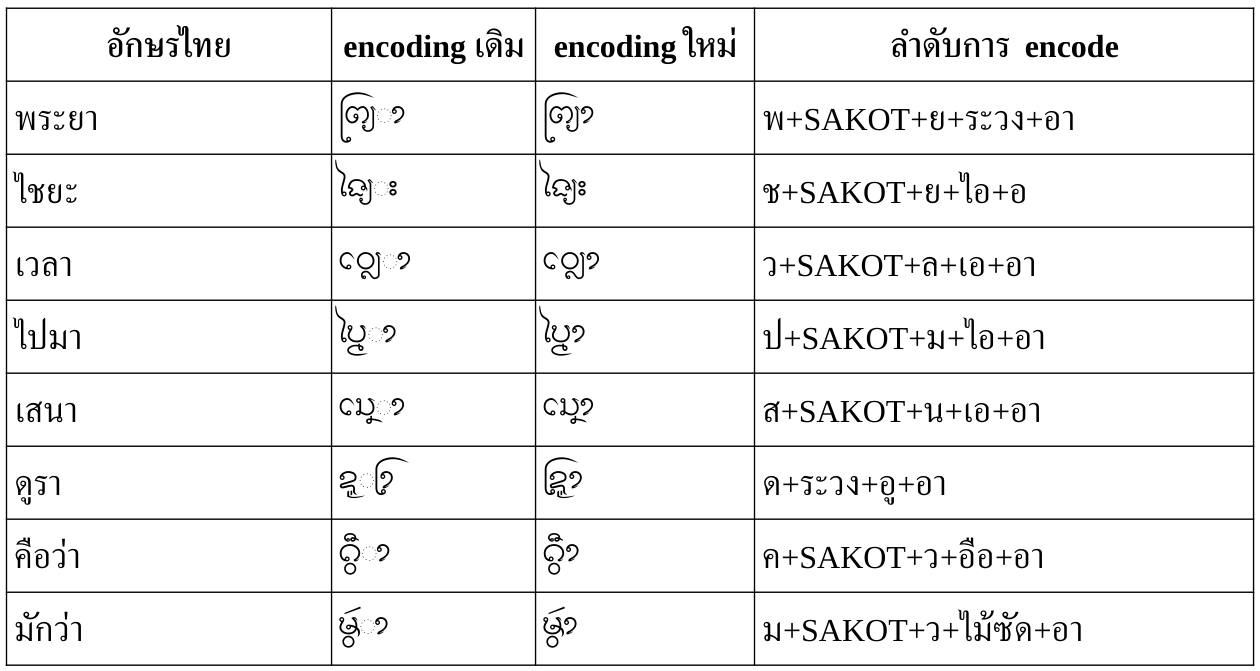
การเขียนอักษรธรรมในหลายกรณีมีการใช้ตัวห้อย/ตัวเฟื้องเป็นพยัญชนะต้นของพยางค์ถัดไป แทนที่จะใช้ตัวเต็ม ซึ่งในกรณีเหล่านี้ ถ้าวางตัวห้อย/ตัวเฟื้องในตำแหน่งของตัวสะกด ก็จะไม่สามารถวางสระต่อได้อีก เพราะดูเหมือน USE ไม่ได้รองรับ recursion ใน F ตามกฎในร่างฯ และเมื่อแจงต่อไป CC ของพยางค์ถัดไปก็ขาดพยัญชนะต้นตัวเต็ม (C) มาขึ้นต้น CC แต่ถ้า encode โดยเลี่ยงให้ตัวห้อย/ตัวเฟื้องดังกล่าวเป็นส่วนหนึ่งของ CC ของพยางค์ก่อนหน้าก็จะสามารถวางสระต่อได้ แต่ลำดับก็จะดูขัดสามัญสำนึกสักหน่อย

แต่ในบางกรณีก็ไม่เอื้อให้ทำเช่นนั้น เช่น เมื่อมีสระมาคั่นในแบบที่ไม่สามารถสลับลำดับได้

ในคำย่อที่มีการยืมพยัญชนะต้น

บ่อยครั้งที่อักษรธรรมมีการใช้รูปเขียนย่อในลักษณะที่ใช้พยัญชนะต้นตัวเดียวซ้ำในพยางค์มากกว่าหนึ่งพยางค์ ในจำนวนนั้น บางคำอาจสามารถยังจัดลำดับอักขระจนเข้ากับกฎเกณฑ์ของ USE ได้ แม้จะดูเหมือนการเปลี่ยนหน้าที่อักขระ เช่น เปลี่ยนตัวสะกดมาเป็นตัวควบ หรืออาจมีการสลับลำดับสระของพยางค์ต่างๆ

แต่บางกรณีก็ไม่สามารถจัดลำดับให้เข้าเกณฑ์ได้

วิธีหลบเลี่ยง?

อย่างไรก็ดี ปัญหาทั้งหมดนี้สามารถหลบเลี่ยงได้ โดยลบ glyph DOTTED CIRCLE (uni25CC) ออกจากฟอนต์เสีย แล้ว USE ก็จะไม่แสดง dotted circle อีกเลย!

ที่กล่าวมาทั้งหมดนี้คือการทดสอบกับแอปที่ใช้ Harfbuzz แต่สุดท้าย เมื่อนำไปทดสอบกับ MS Word ปรากฏว่ามันก็ยังไม่ยอมง่ายๆ อยู่ดี โดยปัญหาหลักที่พบมีสองข้อ ข้อแรกคือกฎของตัวห้อย/ตัวเฟื้องจะไม่ทำงานถ้าไม่ได้ตามหลังพยัญชนะต้นทันที เช่น เป็นตัวสะกดของสระอา หรือมีสระอื่นมาคั่นกลาง กล่าวคือ blwf ดูจะถูกเรียกเฉพาะในตำแหน่งพยัญชนะซ้อนกันเท่านั้น ไม่เรียกในตำแหน่งตัวสะกด และอีกข้อหนึ่งคือกฎ ligature สำหรับ นา ไม่ทำงานเมื่อมีอักขระซ้อนบน/ล่าง

สรุป

ประเด็นต่างๆ ที่พบ พอจะสรุปได้ตังตาราง

ประเด็น ใช้ USE เลี่ยง USE
วิธีการ
  • lana script tag
  • GSUB ตาม USE
  • ตัด dotted circle
  • DFLT script tag
  • GSUB อย่างละเอียด
  • อาจมี dotted circle ได้
การ encode ข้อความ กึ่ง visual (ขัดสามัญสำนึกนิดหน่อย) ตามหลักการสะกดคำ
แอปที่รองรับ Harfbuzz app*, MS Word (บางส่วน) Harfbuzz app*, Notepad
อาการเมื่อไม่รองรับ
  • MS Word
    • กฎ blwf ในตำแหน่งตัวสะกดไม่ทำงาน
    • กฎ ligature นา ไม่ทำงานถ้ามีอักขระบน/ล่างแทรก
  • Notepad และแอปที่รองรับ OpenType แบบผิวเผิน
    • ไม่มีกฎไหนทำงานเลย
  • ทุกแอป
    • ไม้กั๋งไหลไม่ไหล
  • MS Word
    • ccmp: การ reorder สระหน้า, ระวง ไม่ทำงาน
    • liga: reorder สระหน้าซ้ำสองตำแหน่ง

*Harfbuzz app เช่น LibreOffice, Firefox, Gedit, Mousepad ฯลฯ

จึงพอสรุปได้ว่ายังมีความแตกต่างระหว่างข้อกำหนดในร่างฯ กับสิ่งที่ USE รองรับจริง ทำให้ไม่ว่าจะพยายามอย่างไรก็จะมีข้อบกพร่องเกิดขึ้นเสมอ และแอปที่มีปัญหาเสมอๆ ก็คือ MS Word

หากเลือกใช้ข้อกำหนด USE ทุกแอปที่รองรับ USE ก็จะได้การรองรับแบบ เกือบๆ ครบถ้วน (โดย MS Word จะมีปัญหามากกว่าเพื่อนสักหน่อย) โดยแลกกับลำดับการ encode ที่ผิดธรรมชาติของผู้ใช้ ซึ่งเป็นการแลกที่ผมคิดว่าไม่คุ้ม เพราะจะมีผลให้เกิดเอกสารที่ encode แปลกๆ เกิดขึ้นในระหว่างที่ USE ยังไม่พร้อม แถมสิ่งที่ได้คืนมาก็ยังไม่ใช่สิ่งที่สมบูรณ์เสียด้วย

ในขณะที่หากเลือกหลีกเลี่ยง USE แอปส่วนใหญ่ยกเว้น MS Word ก็จะสามารถจัดแสดงอักษรธรรมได้สมบูรณ์ (ดังกล่าวไว้ใน blog ที่แล้ว) โดยที่ผู้ใช้ก็ยังคงใช้ encoding แบบเก่าได้เช่นเดิม และเมื่อไรที่ USE พร้อม ก็เพียงแปลง encoding ไปเป็นแบบใหม่ (ซึ่งอาจจะอัตโนมัติหรือ manual ก็ค่อยว่ากัน) โดยไม่ต้องมี encoding ชั่วคราวของ USE มาแทรกกลางเป็นชนิดที่สามให้เกิดความสับสนเพิ่ม โดยแลกกับการทิ้ง MS Word ที่ยังไงก็ไม่สมบูรณ์อยู่แล้ว และแนะนำให้ผู้ใช้อักษรธรรมใช้ LibreOffice หรือ Notepad (ซึ่งเป็นผลพลอยได้) ในการเตรียมเอกสารแทน ส่วนเว็บเบราว์เซอร์นั้นไม่เป็นปัญหา เพราะเบราว์เซอร์ส่วนใหญ่ก็ใช้ Harfbuzz เป็นฐานกันอยู่แล้ว การรองรับก็จะเหมือนๆ กับใน LibreOffice นั่นแล

ด้วยเหตุนี้ ผมจึงเลือกที่จะสร้างฟอนต์อักษรธรรมที่ หลีกเลี่ยง USE ต่อไป จนกว่า USE จะพร้อมจริงๆ

ป้ายกำกับ: , ,

02 กุมภาพันธ์ 2555

Unicode 6.1 and Thai-Lao Scripts

Blognone ออกข่าว Unicode 6.1 ออกแล้ว โดยมีการกล่าวถึงการแก้ปัญหา Grapheme Cluster Boundaries ซึ่งเป็นปัญหาภาษาไทยใน UAX #29 ผมได้พูดถึงเรื่องนี้ประปรายใน blog เก่า (เช่น เมื่อ 16 มี.ค. 2552 และ 6 ต.ค. 2553) แต่ไม่เคยเขียนถึงเป็นเรื่องเป็นราวโดยตรง

ปัญหาของ UAX #29 ในส่วนของ grapheme cluster boundary นี้ก็คือ มันได้กำหนด cluster ซึ่งเป็นหน่วยที่เล็กที่สุดของการตัดบรรทัดและเลื่อนเคอร์เซอร์ โดยให้สระหน้าและสระหลังของอักษรไทยและลาวถูกนับรวมไปใน cluster เดียวกับพยัญชนะที่มันเกาะ แทนที่จะแยกเป็น cluster อิสระ เช่น:

|เป็|น|เรื่|อ|ง|เป็|น|รา|ว|

แทนที่จะเป็น:

|เ|ป็|น|เ|รื่|อ|ง|เ|ป็|น|ร|า|ว|

การแบ่ง cluster แบบนี้มีผลดีคือเวลาตัดบรรทัดจะไม่ตัดในจุดที่รู้แน่ว่าไม่ควรตัด เช่น หลังสระเอ หน้าสระอา (ซึ่งความจริงก็ไม่ได้มีประโยชน์มาก ถ้าเรามี engine สำหรับตัดคำอยู่แล้ว) แต่ผลข้างเคียงก็คือ มันทำให้การเลื่อนเคอร์เซอร์ของภาษาไทย-ลาวในโปรแกรมต่าง ๆ ผิดเพี้ยนไปจากที่ผู้ใช้คาดหวัง ดังจะเห็นได้จากบั๊กที่ file ไว้ในที่ต่าง ๆ เช่น:

เรื่องนี้เกิดจากข้อกำหนดเรื่อง extended grapheme cluster ซึ่งใน UAX #29 ฉบับเดิมกำหนดให้สระหน้าของไทย-ลาว (เอ, แอ, โอ, ใอ, ไอ, ເອ, ແອ, ໂອ, ໃອ, ໄອ) มีคุณสมบัติ Grapheme_Cluster_Break เป็นแบบ Prepend และสระหลังของไทย-ลาว (อะ, อา, อำ, ອະ, ອາ, ອຳ) มีคุณสมบัติเป็นแบบ Extend ซึ่งอักษรที่มีคุณสมบัติเหล่านี้จะไม่สามารถยืนเป็น cluster เดี่ยว ๆ ได้ ต้องเกาะไปกับพยัญชนะ โดยแบบ Prepend ต้องเกาะไปกับพยัญชนะที่ตามมา และแบบ Extend ต้องเกาะไปกับพยัญชนะที่มาก่อนหน้า ซึ่งตรงนี้เป็นพฤติกรรมปกติในอักษรตระกูล Indic ซึ่งรวมถึงอักษรพม่าและเขมรด้วย แต่เผอิญเขาอาจจะลืมว่าอักษรไทย-ลาวเป็นอักษร Indic ที่แหกคอก

ความจริงแล้ว UAX #29 ฉบับเดิมได้กำหนดว่า นี่เป็นเพียงพฤติกรรม ปริยาย เท่านั้น ระบบต่าง ๆ สามารถ ดัดแปลง (tailor) ไปตามที่เห็นสมควรได้ แต่นั่นก็ไม่น่าสนใจเพียงพอให้นักพัฒนาระบบต่าง ๆ ดัดแปลง ตามที่ผู้ใช้คาดหวังโดยพร้อมเพรียงได้

ผมจึงได้หารือกับคุณ Martin Hosken เพื่อขอแก้ข้อกำหนดนี้ คุณ Martin เห็นด้วยว่าควรแก้ที่ข้อกำหนดโดยตรง เพราะถึงอย่างไร พฤติกรรมที่ ดัดแปลง นี้ จะเป็นสิ่งที่ทุกระบบจะต้องทำโดยปริยายอยู่แล้ว แล้วทำไมจะไม่ทำให้มันเป็นพฤติกรรมปริยายไปเลยล่ะ?

การทำให้คณะกรรมการยูนิโค้ดเชื่อไม่ใช่เรื่องง่าย ในเมื่อข้อกำหนดเดิมได้เปิดช่องให้ดัดแปลงได้อยู่แล้ว เขาจึงไม่เห็นความจำเป็นต้องแก้ร่างเดิม เราต้องหาหลักฐานที่หนักแน่นพอที่จะทำให้เขาเชื่อว่าไม่มีใครต้องการพฤติกรรมปริยายของเขาเลย การดัดแปลงเป็นสิ่งจำเป็น ไม่ใช่ตัวเลือก นั่นแหละเขาถึงจะยอมแก้

ความจริงก็ได้ยินมาว่ามีตัวแทนจาก Apple ที่อเมริกาเสนอแก้เรื่องนี้ไปรอบหนึ่งแล้วเหมือนกัน แต่ก็ตกไป นั่นยิ่งทำให้เราต้องหาหลักฐานที่หนักแน่นยิ่งขึ้น รายงานบั๊กต่าง ๆ ในโลกโอเพนซอร์สช่วยยืนยันได้ในระดับหนึ่ง แต่หลักฐานในเอกสารจริงว่าไม่มีใครแบ่ง cluster แบบนั้นเลยจะช่วยตีประเด็นได้ผลกว่า ผมได้ขอร้องให้เพื่อน ๆ ช่วยหาตัวอย่างป้ายข้อความแนวดิ่งที่แสดงตัวอักษรทีละช่องโดยเห็นสระหน้า-หลังแยกจากพยัญชนะ ก็ปรากฎว่าหายากเหลือเกิน ส่วนมากป้ายแนวดิ่งจะเขียนทีละพยางค์มากกว่า ในเวลาเดียวกันก็พยายามหาหลักฐานแนวอื่น จนกระทั่งไปเจอ การทำ drop cap ในวารสารที่แสดงให้เห็นการแบ่ง cluster ในเอกสารจริง

ด้วยการประสานงานของคุณ Martin การแก้ข้อกำหนดในครั้งแรก เขาแก้เป็น clustering สองแบบ คือแบบ extended กับแบบ legacy โดยแนะนำให้ใช้แบบ extended ยกเว้นภาษาไทย-ลาวที่อาจจะใช้แบบ legacy แทนได้ ฟังดูเหมือนเริ่มโอนอ่อนลงบ้าง แต่ก็ยังไม่กระตุ้นนักพัฒนามากพออยู่ดี จนกระทั่งคุณ Martin ได้ยื่นหลักฐานภาพ drop cap ของผมเข้าไป ผมเองก็คิดว่าคงได้แค่นั้นแหละ จนกระทั่งมาได้ข่าวจาก Blognone จึงตรวจสอบดู ก็ปรากฏว่าเขาแก้โดยตัดเรื่อง Prepend และ Extend ในส่วนภาษาไทย-ลาวออกไปหมดแล้ว ยกเว้นสระอำ โดยย้ายมาอยู่ในหมวด SpacingMark ซึ่งผลคือจะยังคงให้สระอำเกาะไปกับพยัญชนะนำหน้าต่อไป โดยจะอยู่ในโหมด extended grapheme cluster เท่านั้น ถ้าเป็นโหมด legacy ก็จะให้เคอร์เซอร์ตกหน้าสระอำได้ ส่วนสระหน้า-หลังอื่น ๆ จะแยกเป็น cluster ได้อย่างอิสระตามความคาดหวังของผู้ใช้

งานนี้ต้องให้เครดิตคุณ Martin Hosken เต็ม ๆ ครับ ที่ช่วยประสานงานและชี้แนะแนวทางต่าง ๆ ให้

ขั้นต่อไปคือขอแก้ GNOME #576156 ตามข้อกำหนดใหม่นี้ หรือไม่ก็รอนักพัฒนา Pango ปรับโค้ดใหม่ตามข้อกำหนดใหม่ก็อาจจะเพียงพอ ส่วนในที่อื่น ๆ เช่น ICU และ Chromium เข้าใจว่าเขาแก้ไปนานแล้ว

ป้ายกำกับ: , , ,

hacker emblem